NOTE · 2026笔记 · 2026
我在生物医学研究里怎么用 AI
整理自我的分享“AI for Biomedicine”:我怎么用 AI 规划、跑实验和写报告,怎么用它做研究工具和 slides,以及为什么分数好的模型,到了医院不一定有用。
9 月我做了一个分享,题目叫“AI for Biomedicine”,听众是 Richard Song 通过 OpenRefinery 聚起来的一群研究者。起因是一次聊天。Richard 说我对医学 AI 有不少 insight,可以拿出来分享,我心里想的是“什么 insight?”。他又问我以前有没有跟别人讲过,我说没有,刚才那些都是随口说的。我才发现自己从来没有把这些想法整理过,一直是想到哪说到哪。这篇是整理过的版本。
AI 在我的工作里是两样东西:我研究的对象,和我做研究用的工具。
我做的研究
我在 Stanford 做癌症影像,主要是肺部 CT。我一直觉得,做 AI 研究说到底绕不开三块:数据、训练、评估,生物医学也一样。下面各挑一个我做过的项目讲。
数据。 医生看一个患者,不会只看片子,还会开验血,看病史。大多数影像模型只看图像。新冠第一波在中国暴发的时候,我们把入院前后的胸部 CT、临床信息和化验结果放在一起,预测 2,362 名患者会不会进 ICU、要不要上呼吸机、会不会死亡。外部验证里,在我们比较过的几种组合中,三个结局上都是全部信息结合起来的 AUROC 最高(文章)。
训练。 医学里的 label 很贵,要专家花时间,要做额外的检查,或者要随访好几年。我们训练了一个 3D variational autoencoder,只让它重建肺部病灶周围的 CT patch,不用任何结局 label,再把它学到的东西拿去做别的任务。预测 KRAS 突变状态和淋巴结分期,它的特征和 radiomics 特征差不多,而 radiomics 还多用了一个手画的病灶 mask。在学到的 representation 里沿一个方向移动,生成的病灶会变小或变大,从这里能看出模型学到了什么。这些是生成的图像,不是对某个患者肿瘤的预测(文章)。
评估。 一个模型在自己的测试集上很好,换一家医院常常就不行了。我们把已发表的胸片模型拿到公开数据集和私有的医院数据集上都跑了一遍。肺炎这一项,八个模型在南京成人胸片上的平均 AUROC 是 0.81,到了同一地区的 371 张儿童胸片上只有 0.57。
指标也很关键。AUROC 衡量的是排序。可在临床上,模型其实是一个阈值:分数过了某个值,就得有人去处理。我用一个模型之前,会先把 sensitivity 固定在 95%,也就是每 100 个阳性病例最多漏掉 5 个,再看它还能排除掉多少阴性病例。这个单看 AUROC 是看不出来的(文章)。
研究循环
我做研究基本是一个循环:定问题,排实验,跑,汇总,解释,写出来。写完往往又冒出下一个问题。
每个环节我都用一个 skill。skill 就是一份写好的流程,AI agent 照着做,里面写了要检查什么、什么时候停。有些是我装的公开 skill。我自己写的那些,带着别人没有的细节:我们 GPU 的显存上限、数据 cache 是怎么组织的、我要什么样的解释。
环节之间的决定我自己做:哪个问题值得问,先做什么,便宜的那步结果出来之后,值不值得接着跑贵的。这些 agent 不知道。
这是我在分享里讲的循环。方框是写好的流程,菱形是我不交给 AI 的决定。
定义
我一开始只写了一句话,自己觉得挺清楚:把我们的肺部病灶 encoder 用到多模态的任务上。这个 encoder 是一个用 CT patch 训练的 3D 模型。其实具体要做什么,一样都没说。
帮上忙的是 Matt Pocock 的两个公开 skill。grilling 一轮一轮地问我问题,每个问题下面附上它推荐的答案,我改答案就行,不用从头写。domain-modeling 在术语一出现的时候就把它记下来。这样才发现,我们一直混着用 embedding、feature block 和 arm 这三个词,有时说的是同一个东西,有时又不是。
它问我这个实验到底想证明什么:是 CT 的 representation 带来了额外的信息,还是我们有更好的办法把几种模态结合起来。我两个都想要。它推荐用分期和淋巴结状态做结局,我选了生存,因为我想在生存上同时看好几种模态。但生存数据还得申请,可能要等几周。我们先把申请交了,排实验的时候也把这段等待算了进去。
skill 开始问第二轮问题的时候,我把它停了。接着我的规划 skill 把讨论压成四栏:要研究什么、为什么现在做、结果会影响哪个决定、做到什么程度算完。开始规划之前,我会先把这一页改对。
规划
规划 skill 把问题拆成一个个实验,每个实验写清楚跑什么、为什么跑、大概要多少显存和时间,还有出现什么结果就该停。它会问我:这个实验是真的要用上一个实验的输出,还是我只是顺手把它写在了后面。只有前一种才需要等。
如果一个便宜的步骤能决定一个贵的步骤值不值得跑,它就在中间放一个 gate,也就是一个只有我能回答的是非题。估总时间的时候,它把我看结果、回答 gate 的时间也算进去。
规划这步我有两个习惯。一个是用手上最强的 reasoning model,因为计划里错一处,后面每个 run 都要为它付代价;另一个是开始之前自己把计划读一遍。有一次我发现 agent 正在准备申请一个数据集,在起草信,在填表格。这个数据集我早就有了,只是放在另一台服务器上。
运行
实验跑起来以后,我得知道我不在的时候发生了什么。launch skill 启动每个 run 的时候,会把进程、log 文件和预期的输出记下来。status skill 会看进程还在不在、有没有在用 GPU、log 是不是照常在更新、输出文件有没有生成。举个例子,一个 run 的进程还活着,也占着 GPU 显存,但它的 log 已经 45 分钟没动了,平时每五分钟就会写一次。只看进程的话,会以为它好好的。
它还会看 loss,因为进程活着不等于训练有用。我在分享里放的是一个示意报告,数值是编的:
ssl_lr1e-4   RUNNING  61/100
ssl_lr3e-5   RUNNING  58/100
    loss FLAT: improved 0.3% over the second half (1.697 -> 1.691), plateaued
ssl_lr5e-4   RUNNING  22/100
    loss DIVERGED: loss went NaN, the run is producing nothing
三个进程都活着。一个训练正常,一个 loss 已经平了,一个在浪费 GPU。这三个 run 得分开处理。
分享里还有一个示例:我让 agent 启动一个排在 gate 后面的步骤,而那个 gate 我还没回答。它拒绝了,先把跟这个 gate 有关的结果拿给我看,等记下我的回答之后才启动。这里有个局限,我在分享里也讲了:这条规则只写在 skill 里,底下的 launch 脚本其实照样能把 run 启动起来。要确保没过 gate 就启动不了,launch 脚本里也得加检查。
我们共用机器的那些规矩,以前都在我脑子里,现在也这样写了下来。其中一条是:一张 GPU 利用率是零、却占着显存,那它属于别人暂停的任务。
汇总
汇报 skill 开头先给结论,后面再交代怎么跑的、结果怎么读、哪些别再跑。汇报差值之前,它会先检查是不是按实验设计配对的,再算置信区间。这个检查是出过一次错才加的。两个数据 cache 存着同样的病灶,但顺序不一样,第一次分析按行号把它们配起来,结果每个置信区间都窄了大约 10%。这些数字看起来都很合理。可同一个行号,在两个 cache 里对应的是两个不同的病灶。
解释
结果看不懂的时候,我试过一个很火的“explain it like I’m five” skill。它完全照字面来,真把我当成了五岁小孩。accuracy 和 AUROC 是什么我早就知道;我需要知道的是为什么做这个实验,跟什么比,学到了什么。
所以我把这个 skill 改写了。读者设定成一个懂理论、但不了解具体实现的研究者,有点像没来开会、不知道这个实验前因后果的同事。先说是哪个项目、哪个问题,每个代号都要解释,工程上的事要讲清楚。
我用改写后的 skill 重新解释过一份关于我自己结果的笔记。原来那份笔记其实写到了一个问题,但它挂在两个没展开的代号上,我读不懂。重新解释之后就清楚了:笔记里 KRAS 的那个数值,来自 3DINO 的一个 checkpoint,3DINO 是另一个组公开的模型,我们的 encoder 根本不在那组实验里;而笔记里说的提升和 p 值,来自我们的 encoder 跟它自己 baseline 的比较。这两样撑不起同一个结论。
改写后的 skill 也失败过。一次很长的 session 之后,它把每个组件都描述对了,却始终没说这个项目是做什么的。这次失败现在也写进了 skill。
写作
画图的 skill 里放着一套样式规则:颜色、坐标轴、线宽和格式,数据图和示意图都用这一套。这样我不用每次都把同样的格式重新选一遍。
我怎么用这些 skill
skill 不用懂代码也能读。我改那个解释 skill 的时候,就是让 AI 一步步讲给我听,再用自己的话改。所以拿到一个 skill,我一般先改了再用。
改完还得测。Kun Chen 测试了一套流传很广的 coding 指令,这套指令受 Andrej Karpathy 的一些观察启发。他测出来效果反而更差,token 还多用了大约 5%。我自己也碰到过想法不错、用起来反而多出活的 skill。我的测法是:选一个有代表性的任务,用同一个模型跑两遍,一遍用这个 skill,一遍不用,比较质量、得到能接受的结果要花多少时间(包括我修改的时间),还有成本。然后就在这个任务上调这个 skill,比如让它写得更简洁,或者中间不用停下来等我。
做一个没人会出钱的工具
我们的纵向研究要在一个患者的每次扫描上标出每个病灶,再把不同次检查之间的病灶对上。两次检查之间,患者的体位和呼吸会变,病灶的大小和形状也会变。手工做的话,要先找到文件和报告,在每次检查上给每个病灶存一个点和一个 mask,再维护一张表,跟踪每个病灶在几次检查之间的变化。我们自己标的时候,一个患者大概要 20 到 30 分钟,这只是个粗估。
不会有哪个 grant 出钱做这样一个界面,所以我用 AI 做了一个。Lesion Curator 是一个在浏览器里用的 app,两次检查并排显示,两边对齐、一起滚动,上面叠着 pipeline 的检测结果和 mask。我先看肺部区域对不对、两边有没有对齐,再把两次检查里的病灶对上,mask 不对就放 seed point 修,看完体积和趋势再导出。pipeline 先预测,人再修正;修改单独保存,原始扫描不会动。
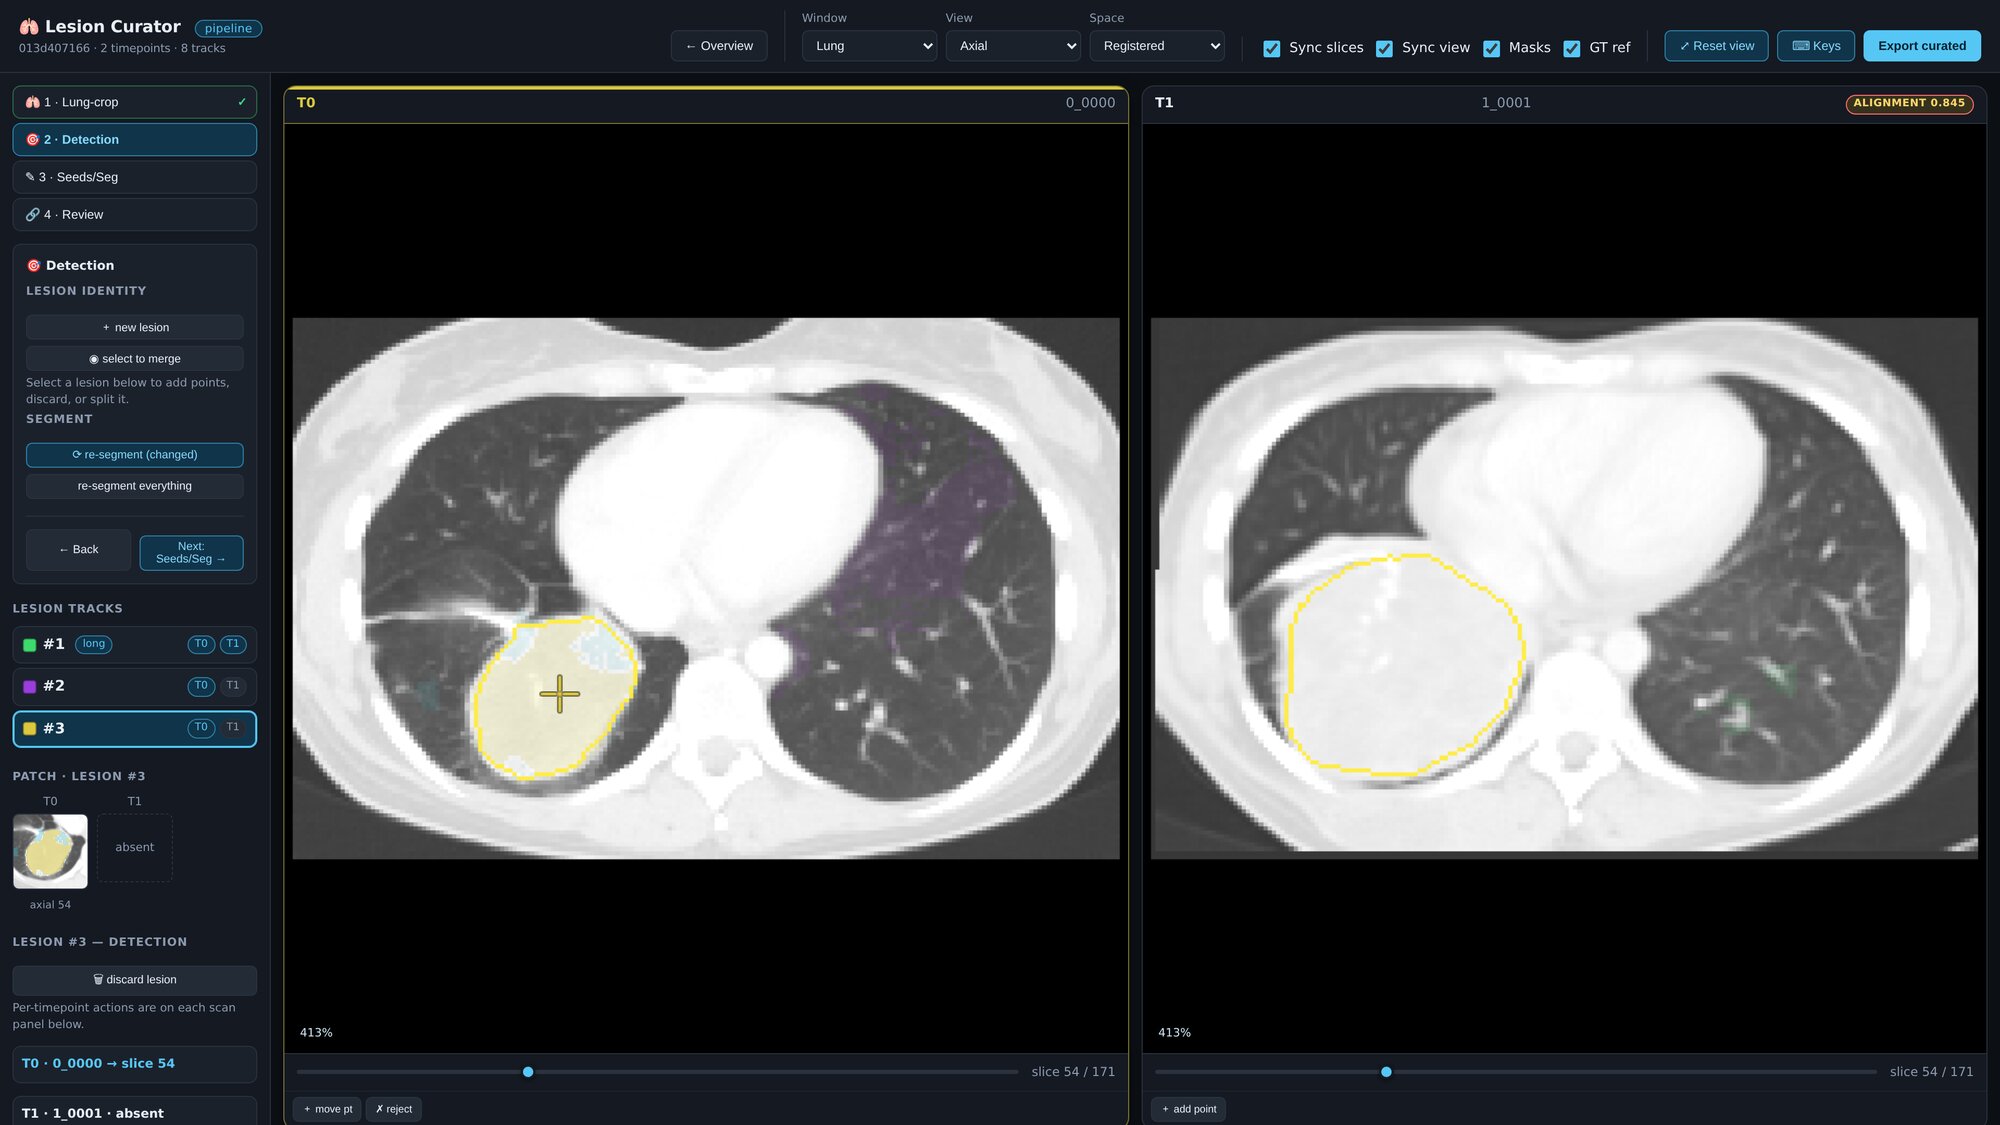 同一个患者的两次检查。pipeline 在第一次检查上检测到了病灶并画了 mask;第二次检查上,黄色的参考轮廓标出了一个它没检测到的病灶,这正是审阅的人要修的那种漏检。CT 来自 autoPET Longitudinal-CT dataset(FDAT Tübingen,doi:10.57754/FDAT.75kj1-64747),CC BY 4.0。
界面是在大家用的过程中一点点改出来的。第一个审阅的人是我,然后是一位在做博士后研究的放射科医生。操作原来在侧栏里,后来挪到了每张扫描下面,这样操作就挨着它对应的图像。审阅的人想看到体积的变化。标趋势原来要拖一条分界线,再在六个 label 之间来回切,太复杂了,后来改成每次检查上一个小标签,点开从菜单里选。它现在还是一个在开发中的研究工具,能不能省时间、能不能提高标注质量,还得做一个 reader study 才知道。
做 slides
这次分享的 slides 也是这么做的。我让 AI 把 Stanford 的视觉识别指南转成一份纯文本的设计规则,再加上一些 slides 专用的规则,比如最小字号、来源怎么标,然后在 Claude Design 里把它做成一个 design system 和几个 template。之后我的时间就花在每一页要说什么上。整套 slides 的样式很统一,这部分我基本没管;要改什么,点一下那个元素,说一句话就行。
VAE 病灶大小的那张图,第一版放在一大段解释旁边,图像网格小到没法比较。我想让听众把原始的、缩小的和放大的病灶并排看,所以我们把解释挪进了备注,把网格放大。
好模型还不等于有用的模型
医学里的 AI,和大家现在说的 AI 不太一样。我 9 月 7 日下了一份 FDA 的 AI-enabled 器械列表,1,614 条授权记录里有 1,230 条在放射科,差不多 76%。要说明一下,这数的是记录,不是产品,更不是医院,FDA 自己也说这个列表不全。其中大部分是图像处理和分析:增强图像,测量结构,做 segmentation。SubtleMR 输出增强后的 MRI 图像,NeuroQuant 给出脑体积供医生审阅,MammoScreen 给读片的人标出可疑的地方。最后读片、做决定的还是人。
我在 PubMed 上用两组检索式查了一下,2024 年语言模型的论文数超过了影像 deep learning。我自己的看法是,语言不会吞掉一切。我没办法用文字把一张 CT 描述到别人能准确想象出来的程度。我更倾向于让不同模态共享一部分 representation,同时各自独有的信息也留着。
模型就算有用,结果也得来得及时。Susan Shelmerdine 是 Great Ormond Street Hospital 的儿科放射科医生,她在一次 Stanford IBIIS-AIMI seminar 上讲了一个急诊科的 audit,看的是一个读儿童骨折 X-ray 的 AI 工具。装这个工具之前和之后,医护人员的准确率都在 84% 左右;AI 单独的准确率大约是 88%。这是一个规模不大的前后对照 audit,说明不了 AI 更好。但医护人员的表现几乎没变,而时间点能解释其中很大一部分。
Susan Shelmerdine 在 IBIIS-AIMI seminar 上讲的儿科骨折 audit 里的平均时间。这是平均值,不是每个患者的时间;这个 audit 也不是随机化的。
LungIMPACT 试验覆盖五个 NHS trust、超过 93,000 张胸片。两组都由 AI 读片;在随机分配的日子里,AI 标出来的片子会在报告队列里往前排。胸片报告出得快了,后面的 CT 和确诊却没有跟着快。
LungIMPACT 里的中位时间。确诊时间上的差异没有统计学意义。Woznitza et al., Nature Medicine 2026, Table 2.
一个 NHS trust 的研究看了要让后面的步骤也快起来,需要些什么。可疑胸片之后当天就做 CT,得有人有空读片,有人协调,CT 的时段还要和患者到的时间对得上。固定在清早的两个时段,帮不了晚些来的患者;连午饭时间有没有人顶班都有影响。还得有人跟患者解释片子上看到了什么,而患者来的时候只是来拍一张 X-ray。
在瑞典的 MASAI 试验里,AI 给乳腺钼靶片做分流,大多数片子只要一位放射科医生读,不用两位。筛查读片的工作量下降了 44.3%,癌症检出率没有下降。ambient AI scribe 的例子里,263 名临床医生报告的 burnout 比例在 30 天后从大约 52% 降到 39%,不过那是一个前后对照研究,而且省下来的时间并不总是变成多看病人。
分享最后我讲的是我觉得还缺的东西。模型要能把影像、化验、病史和病理一起用起来。label 贵,跨机构拿数据也难,所以得看看不用 label 能学到多少。评估要放到模型没见过的私有队列和人群上,指标也要贴着实际用法,比如前面说的把 sensitivity 固定在 95%,看还能排除多少阴性病例。
如果你想试试
如果要试,我会先挑一件自己做过很多遍的事,把要求写下来交给 AI。它交回来之后,先看哪里做错了,再回去改那份指令。
分享的录像在这里:https://www.youtube.com/watch?v=Kz_LV64xKjE
如果你也把自己研究里的某一步写成了让 AI 照着做的流程,我很想和我的比一比,尤其是它出错的那个地方。我的各种链接都在我的个人主页上。