CASE · 2026CASE · 2026
入院时用 CT、病历和化验预测新冠重症
这些模型结合胸部 CT、入院记录和化验结果,使用 2019 年 12 月 27 日至 2020 年 3 月 31 日期间收集的患者数据,用来标出哪些患者可能需要重症监护、需要呼吸机,或者可能无法存活。
2020 年初,新冠疫情给医院资源带来了很大压力,包括重症监护床位和机械通气用的呼吸机。在这项研究中,大多数因新冠入院的患者最后出院回家,没有发生这些事件,但有 6.5% 的患者进入了重症监护室(intensive care unit, ICU),其中一部分人后来还接受了机械通气。如果在入院前后就能知道谁可能需要这类治疗,医院就可以密切观察这些患者,并提前安排床位。
这篇文章讲的是一项研究,它想用入院前后本来就有的信息来做这个判断。研究由 Qinmei Xu 和 Xianghao Zhan 牵头,与中国多家医院的临床团队合作完成。我负责设计和验证模型,以及分析数据。
要回答的问题
你去看医生,医生不会只看片子。他们会问你多大年纪、有什么症状、有没有其他疾病,还会开血液检查。每一项告诉他们的东西都不一样。这里的问题是:模型能不能也把这些都用上,用上之后会不会更好。
拿新冠来检验这个问题是合适的。当时在中国,胸部 CT 被广泛用于评估新冠患者,它能直接显示肺炎:受损的肺组织在哪里,有多少。但肺只是整体情况的一部分。年龄、气短,以及血液里的炎症指标,能反映整个身体应对得怎么样。
患者
研究筛查了中国 39 家医院在 2019 年 12 月 27 日至 2020 年 3 月 31 日之间收治的 3,522 名确诊新冠住院患者。我们只保留了入院三天内做过 CT、且结局记录清楚的患者,并排除了 18 岁以下的患者、转院或仍在住院且没有发生不良结局的患者、没有随访的患者,以及不合适的 CT 扫描(例如层厚较厚或有运动伪影),最后剩下 2,362 名。
我们按医院把建模和测试分开,而不是随机划分。来自 17 家医院的 1,662 名患者用来建模(在这组患者内部,按死亡结局分层,随机按 70/30 划分,用来调模型和在模型之间做选择)。另外 700 名来自其他医院,模型在开发阶段从没见过这些医院。这一点很重要,因为不同医院的扫描设备、患者和习惯都不一样,一个只在建模的医院里好用的模型,用处不大。
我们预测了三个结局,每个都作为单独的是非题:入住重症监护室(ICU)、开始机械通气、院内死亡,均以 28 天随访为限。这些事件很少见。2,362 名患者中,有 2,207 名(93.5%)出院回家,没有发生其中任何一项。在 700 名外部患者中,59 人进入 ICU,39 人需要呼吸机,28 人死亡,这几组人有重叠(所有接受过机械通气或死亡的人也都进过 ICU)。
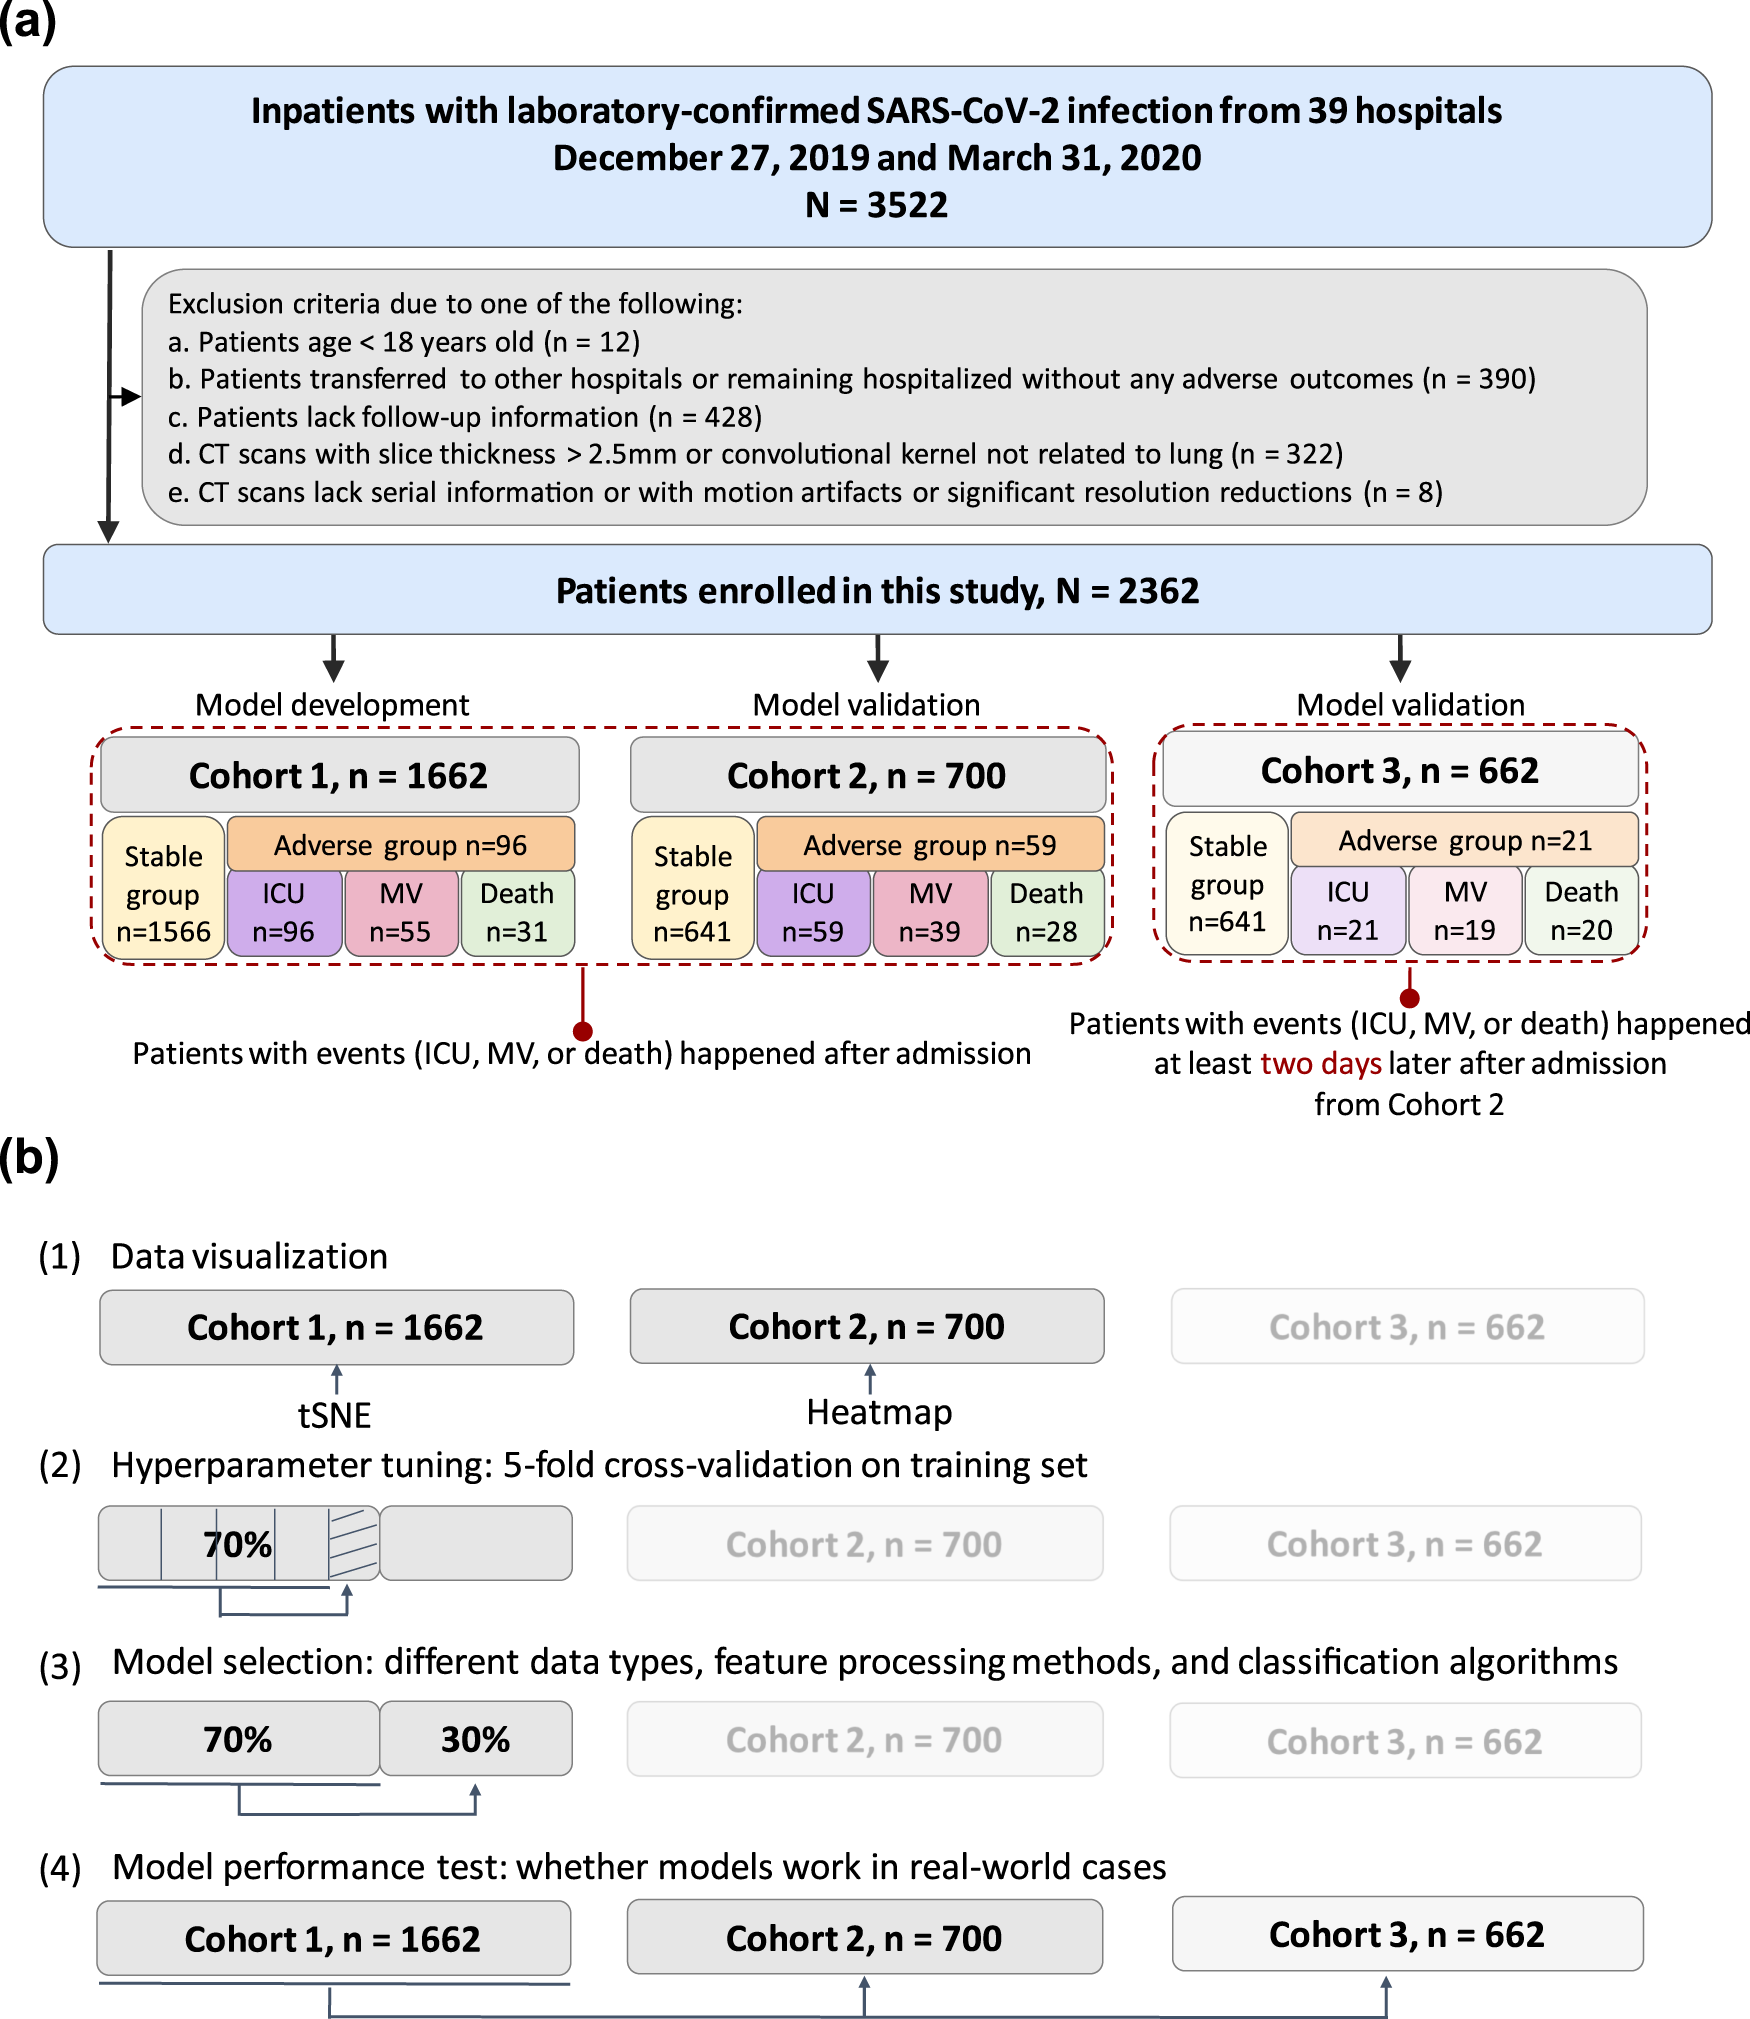 队列是怎么构建和使用的:在一组医院上建模,在来自外部医院的患者上测试。Figure 1, Xu et al., npj Digital Medicine 2021, CC BY 4.0.
把 CT 扫描变成数字
CT(computed tomography,计算机断层扫描)是一组人体的横断面图像,而我们的模型需要的是一串数字。中间分三步。
第一步,一个训练好的神经网络系统在每次扫描中找出并勾画出肺炎区域,也就是新冠在肺里留下的那些雾状和致密的斑片。十名放射科医生审核了所有自动勾画的结果。为了衡量一致性,两名放射科医生在抽取的 100 例扫描上各自独立勾画肺炎区域,他们的勾画和自动勾画的重合度很高(平均 Dice 重合度为 0.95,1.0 表示完全相同)。
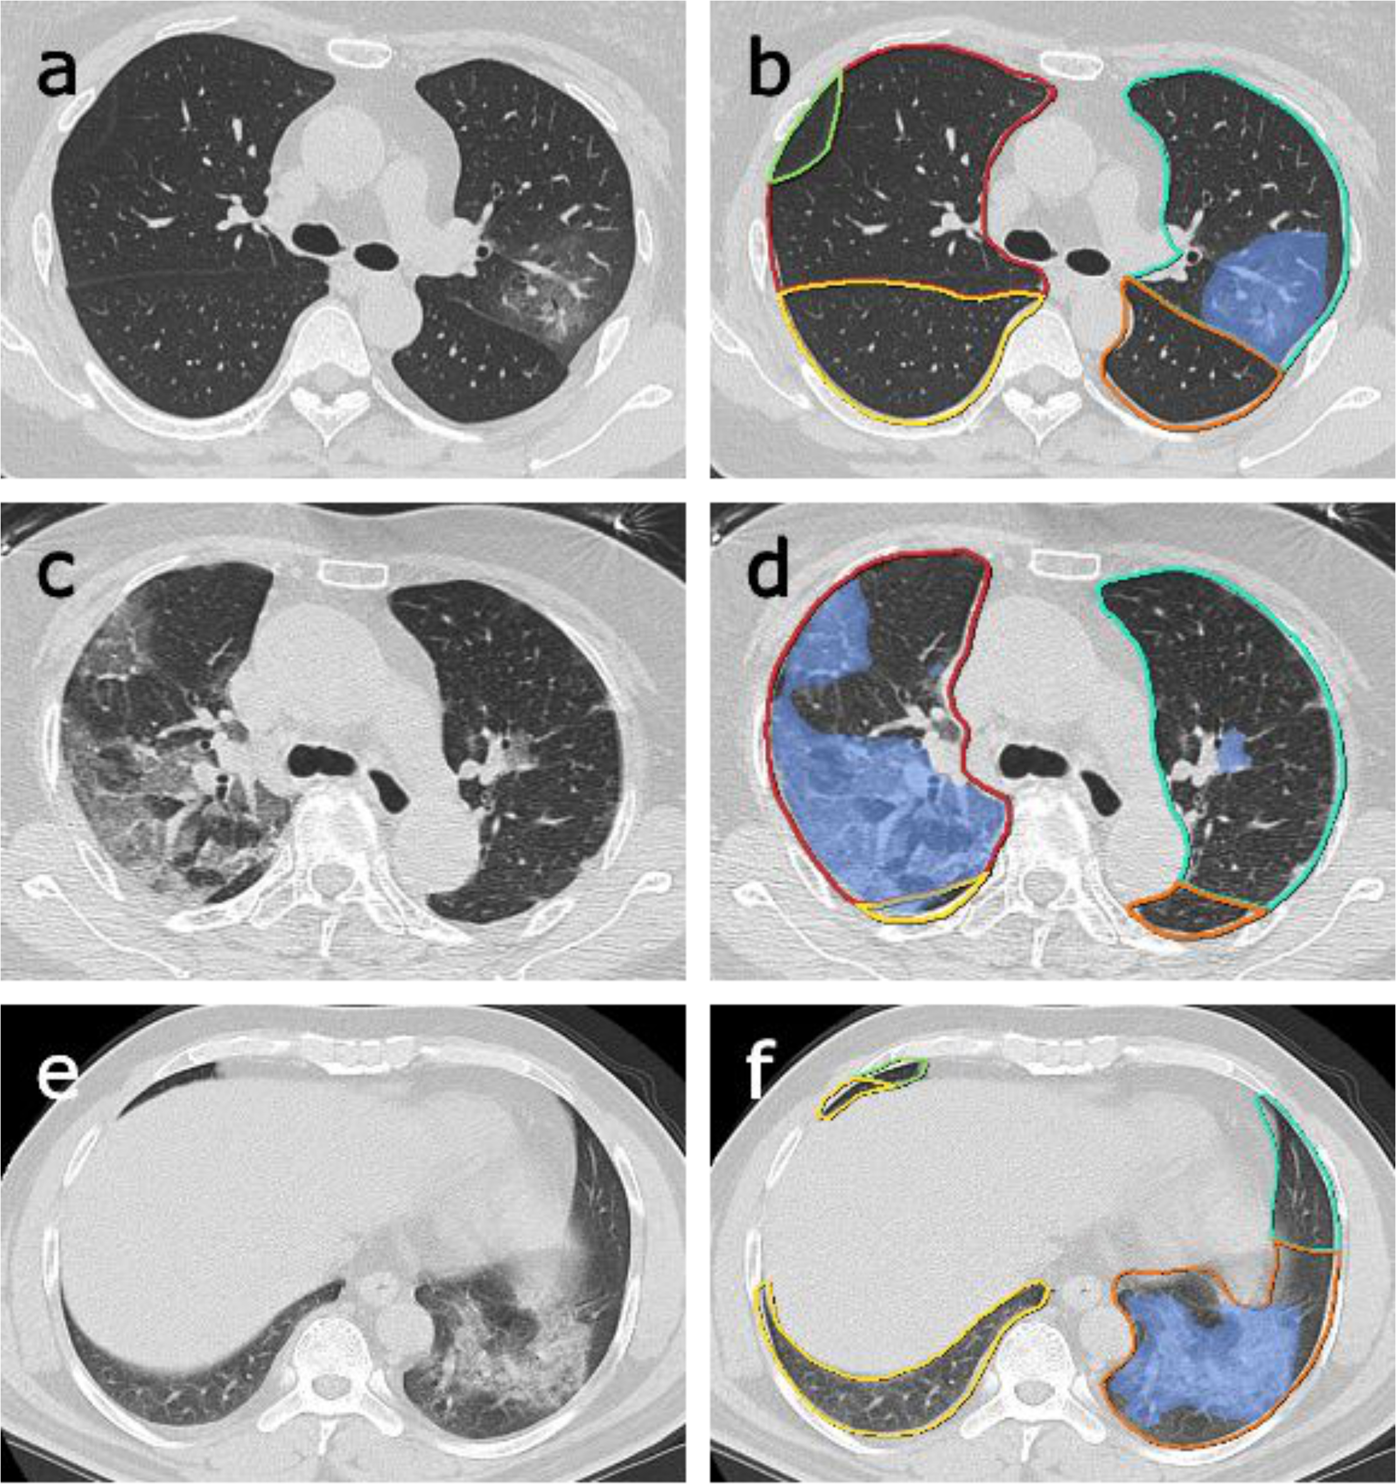 原始 CT 层面(左)和自动分割结果(右):肺叶用彩色勾出,肺炎区域用蓝色标出。Figure 5, Xu et al., npj Digital Medicine 2021, CC BY 4.0.
第二步,对每个勾画出的病灶,我们用开源工具 PyRadiomics 计算了 1,657 个测量值。这种方法叫影像组学(radiomics):用很多数字来描述图像中的一块区域,包括它的大小、形状、亮度和纹理,比如病灶内部看起来是斑驳的还是均匀的。
第三步,一个患者可能有很多病灶,所以我们把每个测量值在这个患者的所有病灶上用六种方式汇总(平均值;中间值;标准差,衡量离散程度;偏度,衡量不对称程度;以及两个分界值,该患者有 25% 和 75% 的病灶值分别低于它们),再加上病灶数量。这样每个患者有 9,943 个 CT 数值。
除此之外还有两组小一些的信息。一组是临床信息,是入院时的 18 个变量:年龄、性别、高血压或糖尿病等其他疾病,以及发热或气短等症状。另一组是化验结果,是入院一天内抽血检查得到的 19 个变量,比如白细胞计数和炎症指标。所有这些都以数字形式输入,并排拼成每个患者一行。这不是一个同时读图像和文本的模型。它比较的是,当不同来源的数字放在同一行里时,结果会有什么变化。
比较不同组合
主要实验是一组比较。对每个结局,我们用不同的输入组合分别训练模型:
- 只用 CT 影像组学
- CT 加临床信息
- CT 加临床信息再加化验结果(完整组合)
- 临床信息加化验结果,完全不用 CT
- 根据放射科医生自己对扫描的描述构建的评分,作为参照,代表专家用肉眼从图像中读出的信息
对前四组输入,我们各试了几种常用的机器学习方法,在建模医院的数据上调参,选出最好的一个,然后才在外部患者上测试。放射科医生评分不一样:它是用他们的描述建立的单个逻辑回归(logistic regression)模型,作为参照。
主要指标是 AUROC:取一个发生了事件的患者和一个没发生的患者,AUROC 就是模型把前者排为更高风险的概率。抛硬币是 0.5,完美排序是 1.0。
结果
在 700 名外部患者中,完整组合在三个结局上对患者的排序都是最好的。论文图 3 中的曲线是在这 700 名外部患者上测得的,对应的 AUROC 值如下:
| 输入 | ICU | 机械通气 | 死亡 |
|---|---|---|---|
| 只用 CT 影像组学 | 0.875 | 0.799 | 0.687 |
| CT + 临床 | 0.919 | 0.881 | 0.802 |
| CT + 临床 + 化验 | 0.944 | 0.942 | 0.860 |
| 临床 + 化验,不用 CT | 0.911 | 0.816 | 0.769 |
| 放射科医生评分 | 0.823 | 0.829 | 0.694 |
论文还报告了在外部患者上做 30 次自助法重抽样(bootstrap resampling)的结果。重抽样反复使用的是同一批患者,并不提供新的独立队列。在这组结果里,完整组合在 ICU 上为 0.916,机械通气为 0.919,死亡为 0.853。这些数字略低一些,但完整组合在三个结局的 AUROC 上仍然排第一。
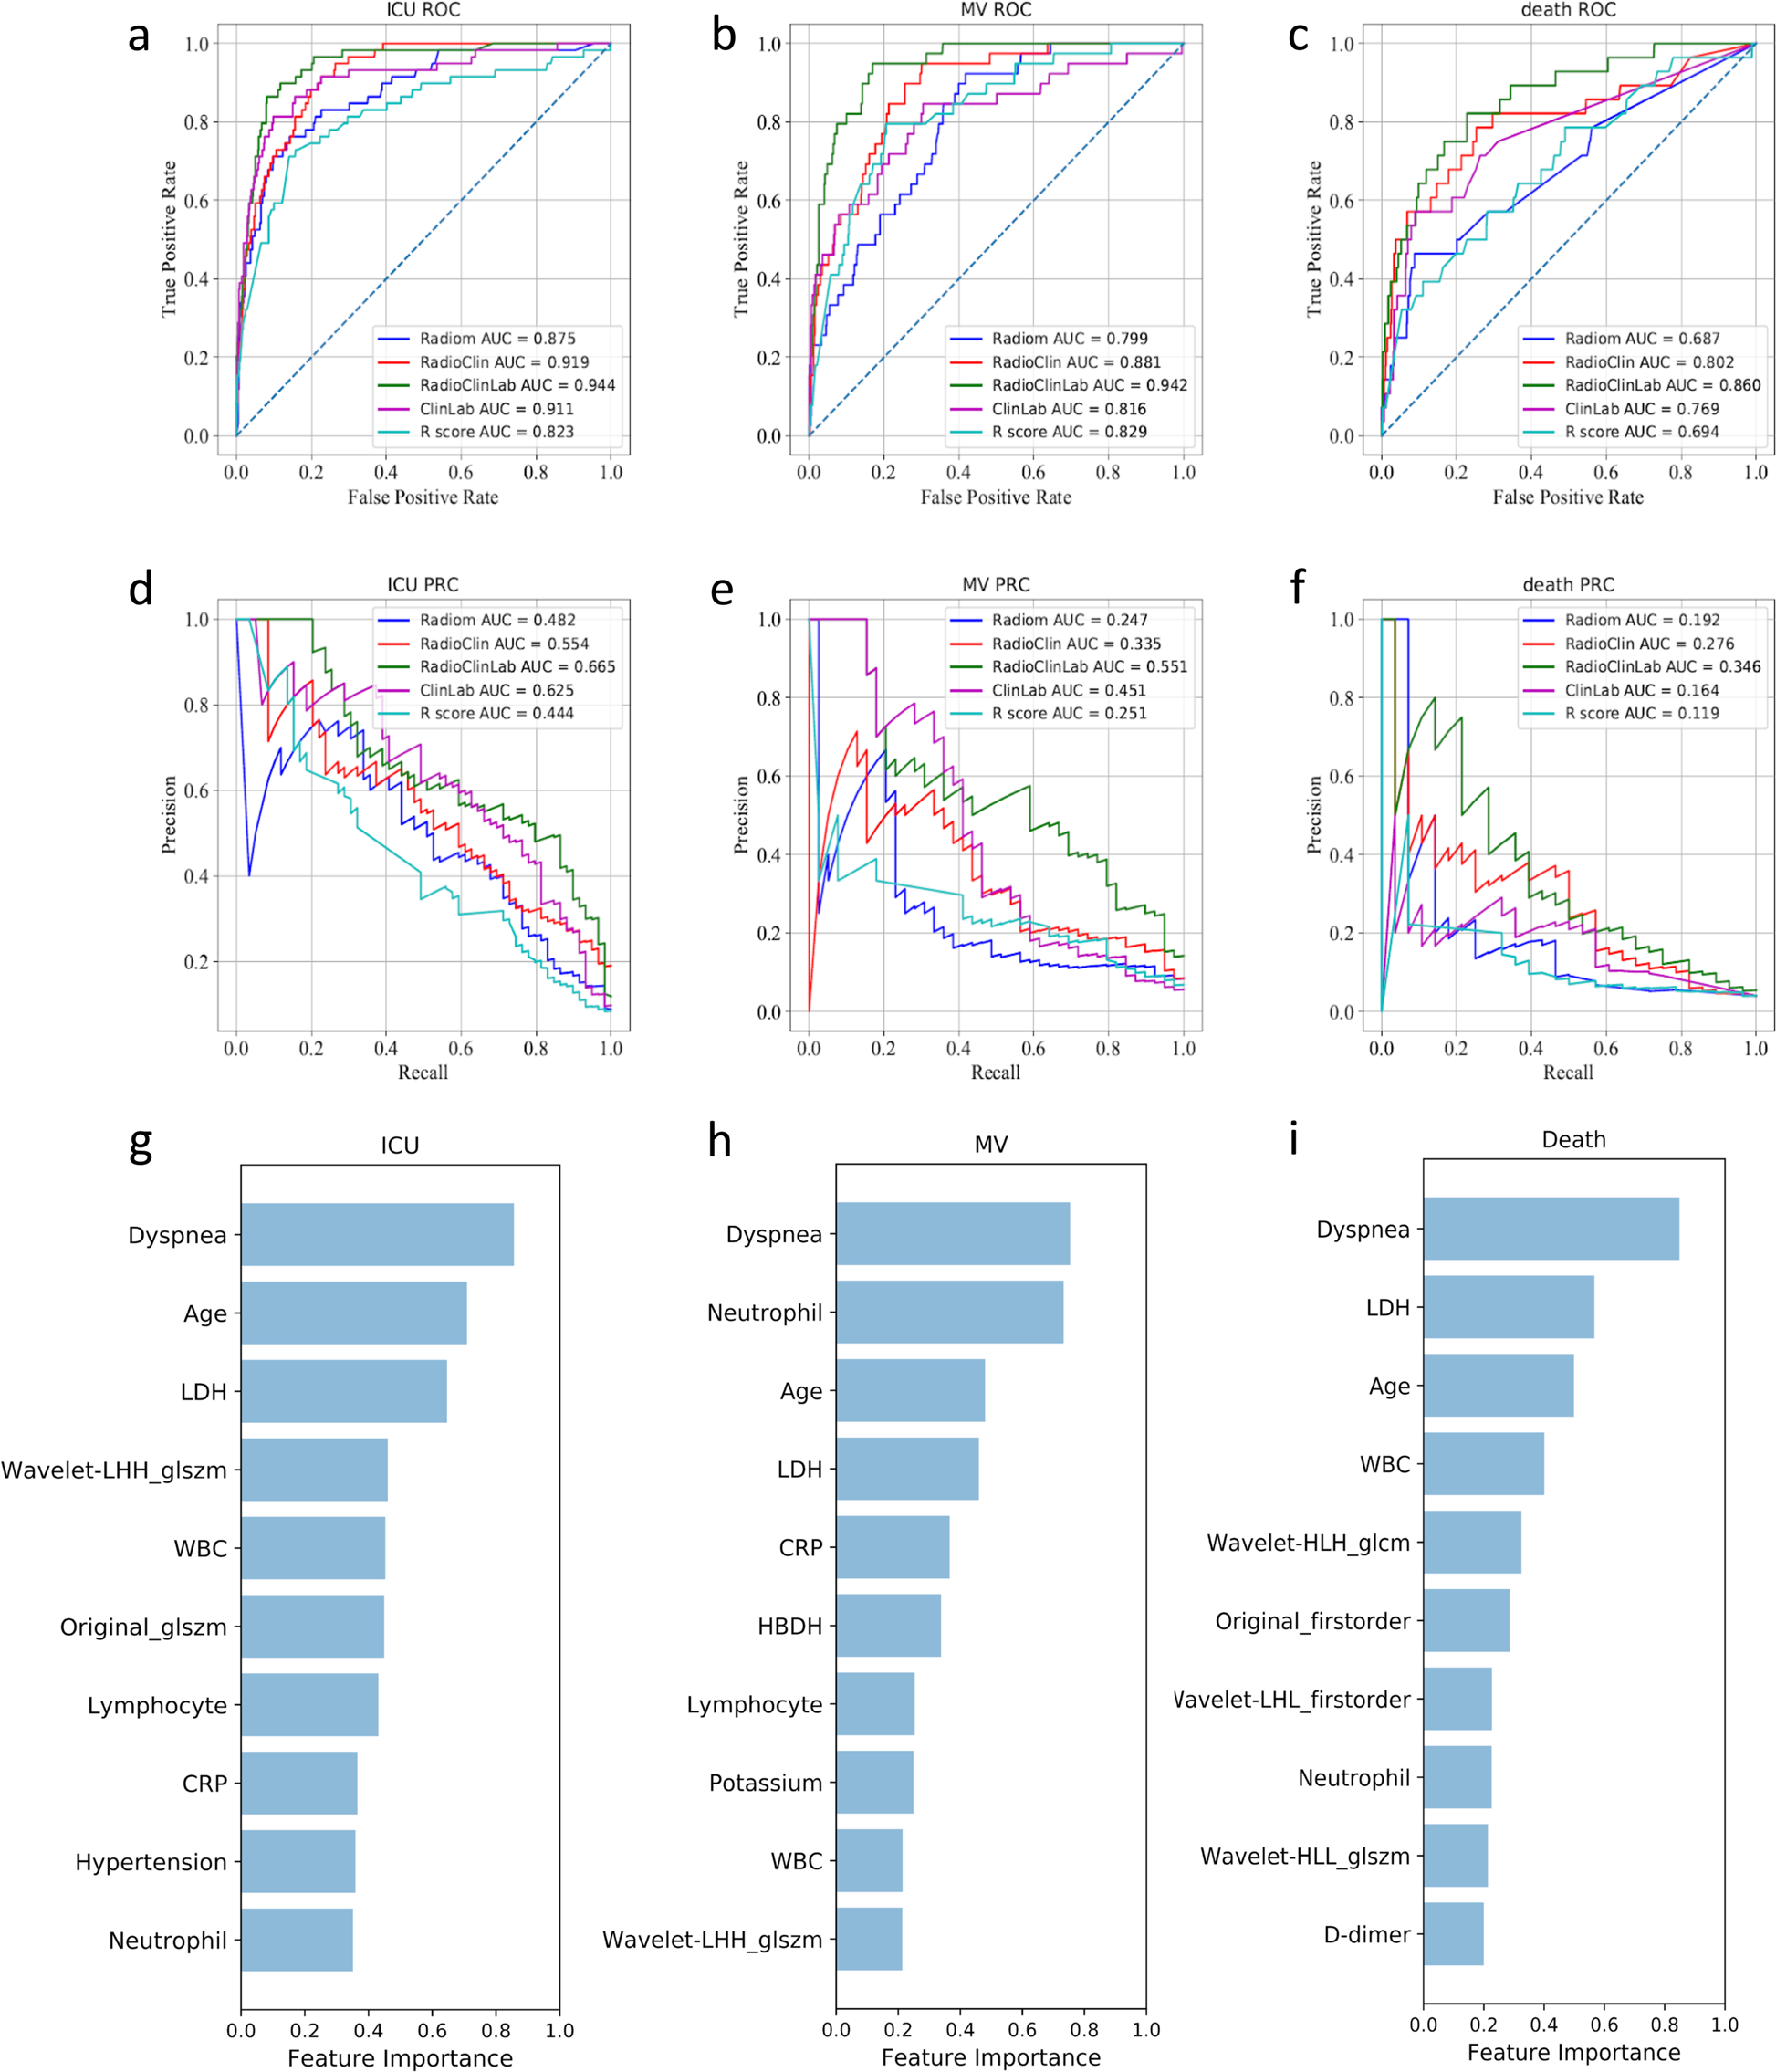 上排:外部患者中 ICU、机械通气和死亡的 ROC 曲线,绿色曲线是完整组合。中排:精确率-召回率(precision-recall)曲线。ROC 曲线比较的是模型检出的真实病例比例和误报率;精确率-召回率曲线比较的是被标记的患者中真正发生事件的比例,和所有事件中被检出的比例。下排:每个结局最重要的十个输入。Figure 3, Xu et al., npj Digital Medicine 2021, CC BY 4.0.
有三点比较突出。
不同来源之间互有帮助。单用 CT 预测 ICU 入住还算可以,但预测死亡很差。单用临床和化验数据预测死亡比 CT 好,但在机械通气上明显不如完整组合(0.816 对 0.942)。合在一起比任何一方单独用都好。我们看了哪些输入最重要(图的下排),每个结局的前十名里两类都有:气短、年龄,以及一项叫 LDH 的血液检查(乳酸脱氢酶,lactate dehydrogenase,一项血液生化指标,数值偏高与重症结局相关)每次都排在前面,旁边还有 CT 纹理测量值。在这些排名靠前的输入里,临床特征和 CT 特征之间没有显著相关,论文认为这说明它们起的是互补作用。一种理解是:CT 描述的是肺里正在发生什么,病历和血液检查描述的是患者身体其他部分的状况。
CT 数值在 ICU 入住上帮助最大。用影像组学建的模型,在 ICU 入住的排序上比根据放射科医生对同一批扫描的描述建立的评分更好,重抽样估计中为 0.869 对 0.776。在机械通气和死亡上,这种优势并不稳定(死亡上是 0.667 对 0.678)。这并不是说软件读片比放射科医生强。研究比较的是放射科医生记录下的 17 个 CT 特征和计算得到的 9,943 个影像组学特征,并没有弄清两者表现差异的原因。
对较晚发生的事件也同样有效。预测如果能在危急情况出现之前给出,会更有用。我们还在 662 名入院头两天没有发生事件的外部患者上做了测试,所以这组人的每个事件都发生在入院两天之后。论文并没有证明每次预测和事件之间都隔了两天。完整组合在这组人上的得分是 0.919、0.943 和 0.856。这组人是那 700 人的一部分,不是另一批患者。
不足之处
这些是回顾既往记录得到的结果,不是在医院里实际使用模型得到的。我们没有证明使用它会改变医生的做法或患者的结局。
所有患者都来自第一波疫情期间的中国医院。其他地方的治疗方式、人群和扫描设备都不同,论文自己也说还需要在欧洲和美国的医院做验证。即使在中国国内,外部医院的患者构成也和建模医院有些不同。
这些事件很少见,这让每个估计都更不确定。700 名患者中只有 28 例死亡,几个病例就能让分数变动。因为事件少见,论文还报告了第二个指标 AUPRC,也就是精确率-召回率曲线下面积。它汇总了在不同阈值下精确率(被标记的患者中真正发生事件的比例)和召回率(实际事件中被模型检出的比例)之间的取舍,解读时要对照这个事件有多常见,而不是把它当成一个偏低版本的 AUROC 来看(重抽样估计中死亡这一项的值为 0.248,对应的基础发生率是 4%)。在这个指标上,完整组合并不总是第一。对死亡,不含化验结果的 CT 加临床信息得分为 0.281。对较晚发生事件的患者中的 ICU 入住,不用 CT 的临床加化验数据得分为 0.446,完整组合为 0.348。所以老实的说法是:在 700 名外部患者中,包括重抽样估计在内,完整组合在这三个任务上的 AUROC 最高,而不是说它在每个指标上、每次比较中都胜出。在论文补充材料的单次运行结果中,对较晚发生事件的患者中的 ICU 入住,单用临床和化验数据的 AUROC 为 0.958,完整组合为 0.948。
最后,那些重要输入只是提示了哪些因素与病情加重同时出现,并不能证明是它们导致了病情加重。
我的收获
有用的信息可能分散在不同类型的数据里。在这项研究中,影像、病历和血液检查各自看到了同一个患者的不同侧面,把它们放在一起得到了最好的排序。这是把多个来源结合起来的理由,也是要分别衡量每个来源贡献了多少的理由,因为收益取决于你关心的是哪个结局、哪个指标。
这是我在研究中反复回到的三个问题里的第一个:我们用什么信息(数据),从中学到什么(训练),以及怎么知道它会有帮助(评估)。这里的工作需要每个患者都有结局标签。下一篇《让模型学会重画肺部病灶,再把学到的东西拿去用》讨论的是,在还没有每个结局的标签时,怎样先学到有用的图像特征。第三篇《八个胸片模型、九个数据集,以及一个分数看不到的东西》讨论的是,一个在留出数据(held-out data)上得分很好的模型,怎么判断它到了一家新医院还能不能站得住。
论文是开放获取的:Xu, Zhan et al., “AI-based analysis of CT images for rapid triage of COVID-19 patients”, npj Digital Medicine 4, 75 (2021), https://doi.org/10.1038/s41746-021-00446-z 。代码在这里:https://github.com/terryli710/COVID_19_Rapid_Triage_Risk_Predictor
我在 OpenRefinery 的演讲 “AI for Biomedicine” 中把这三个项目放在一起讲过。视频在这里:https://www.youtube.com/watch?v=Kz_LV64xKjE