CASE · 2026CASE · 2026
让模型学会重画肺部病灶,再把学到的东西拿去用
一个 3D 变分自编码器在不使用结局标签的情况下,从 CT 影像中学到了肺部病灶的特征。在预测临床结局时,这些特征的表现和影像组学相当。
大语言模型能做得这么好,一部分原因是可供学习的文本极多,而且文本本身就是训练信号:预测下一个词,不需要任何人去做标注。医学影像目前还不是这样。医院里有大量的扫描影像,稀缺的是标签(label):哪些患者有基因突变,谁的癌症已经转移到淋巴结,谁对治疗有反应。每一个答案都要花掉一位病理医生的工作、一次基因检测,或者好几年的随访。
这个项目想做的是:在决定要预测什么之前,先只从影像本身学到关于肺部病灶的有用信息,再把学到的东西用在几个不同的问题上。
把影像变成数字的两种现有做法
要用 CT(computed tomography,计算机断层扫描)影像预测任何东西,首先要把图像变成模型能处理的数字。常见的做法有两种。
第一种是影像组学(radiomics)。专家事先定义一长串测量指标(形状、大小、亮度统计量、纹理模式),由软件从病灶上计算出来,通常要用到一个精确勾画病灶边界的掩膜(mask)。我们用来对比的工具 PyRadiomics 能生成 1,600 多个这样的特征。这些特征的含义大家都很清楚,但它们是固定的:不管你问的是什么问题,这张清单都不会跟着变。
第二种是直接针对你关心的结局训练一个卷积神经网络(convolutional neural network, CNN,一种自己学习图像滤波器的模型)。这种做法能适应具体的问题,但依赖有标签的样本。在我们的对比里,每个问题都单独训练了一个 CNN,所以每来一个新问题,就需要新的标签和一个新的模型。
思路:通过重画来学习
我们用的是变分自编码器(variational autoencoder, VAE)。它分为两半。编码器(encoder)看病灶周围的一小块 3D CT,把它压缩成一串很短的数字。解码器(decoder)拿到这串数字,试着把原来那块影像重画出来。模型的评分标准就是重画结果和原图有多接近。
关键在于压缩。这块影像有 32 x 32 x 32 个体素(voxel,即 3D 像素),所有扫描都重采样到 1 mm 间距之后,每条边大约 3 cm,总共大约 33,000 个数值。编码器必须用 1,024 个数字来描述它,另外再用对应的 1,024 个数字描述它对每个数字有多不确定。要想通过这个瓶颈把影像重画好,模型必须保留足够多的病灶信息,才能把它重建出来。没有人告诉它该保留什么,而它保留下来的东西在临床上有没有用,需要另外检验。这一步训练完全不用结局标签。
“变分”的意思是,编码器对每个数字输出的不是单个值,而是一个均值和一个标准差(也就是一个钟形的高斯分布),同时有一个由系数 beta 加权的惩罚项,把这些分布往标准高斯分布上拉(所以叫“beta-VAE”)。我们的 beta 设得非常小(0.00001),所以模型主要被推着去准确地重画。
做预测时,我们把解码器放到一边,让每个病灶过一遍编码器,再把两组各 1,024 个数字(均值和分布宽度,一共 2,048 个特征)交给 XGBoost(一种常用的基于树的分类器),去预测每一个临床结局。
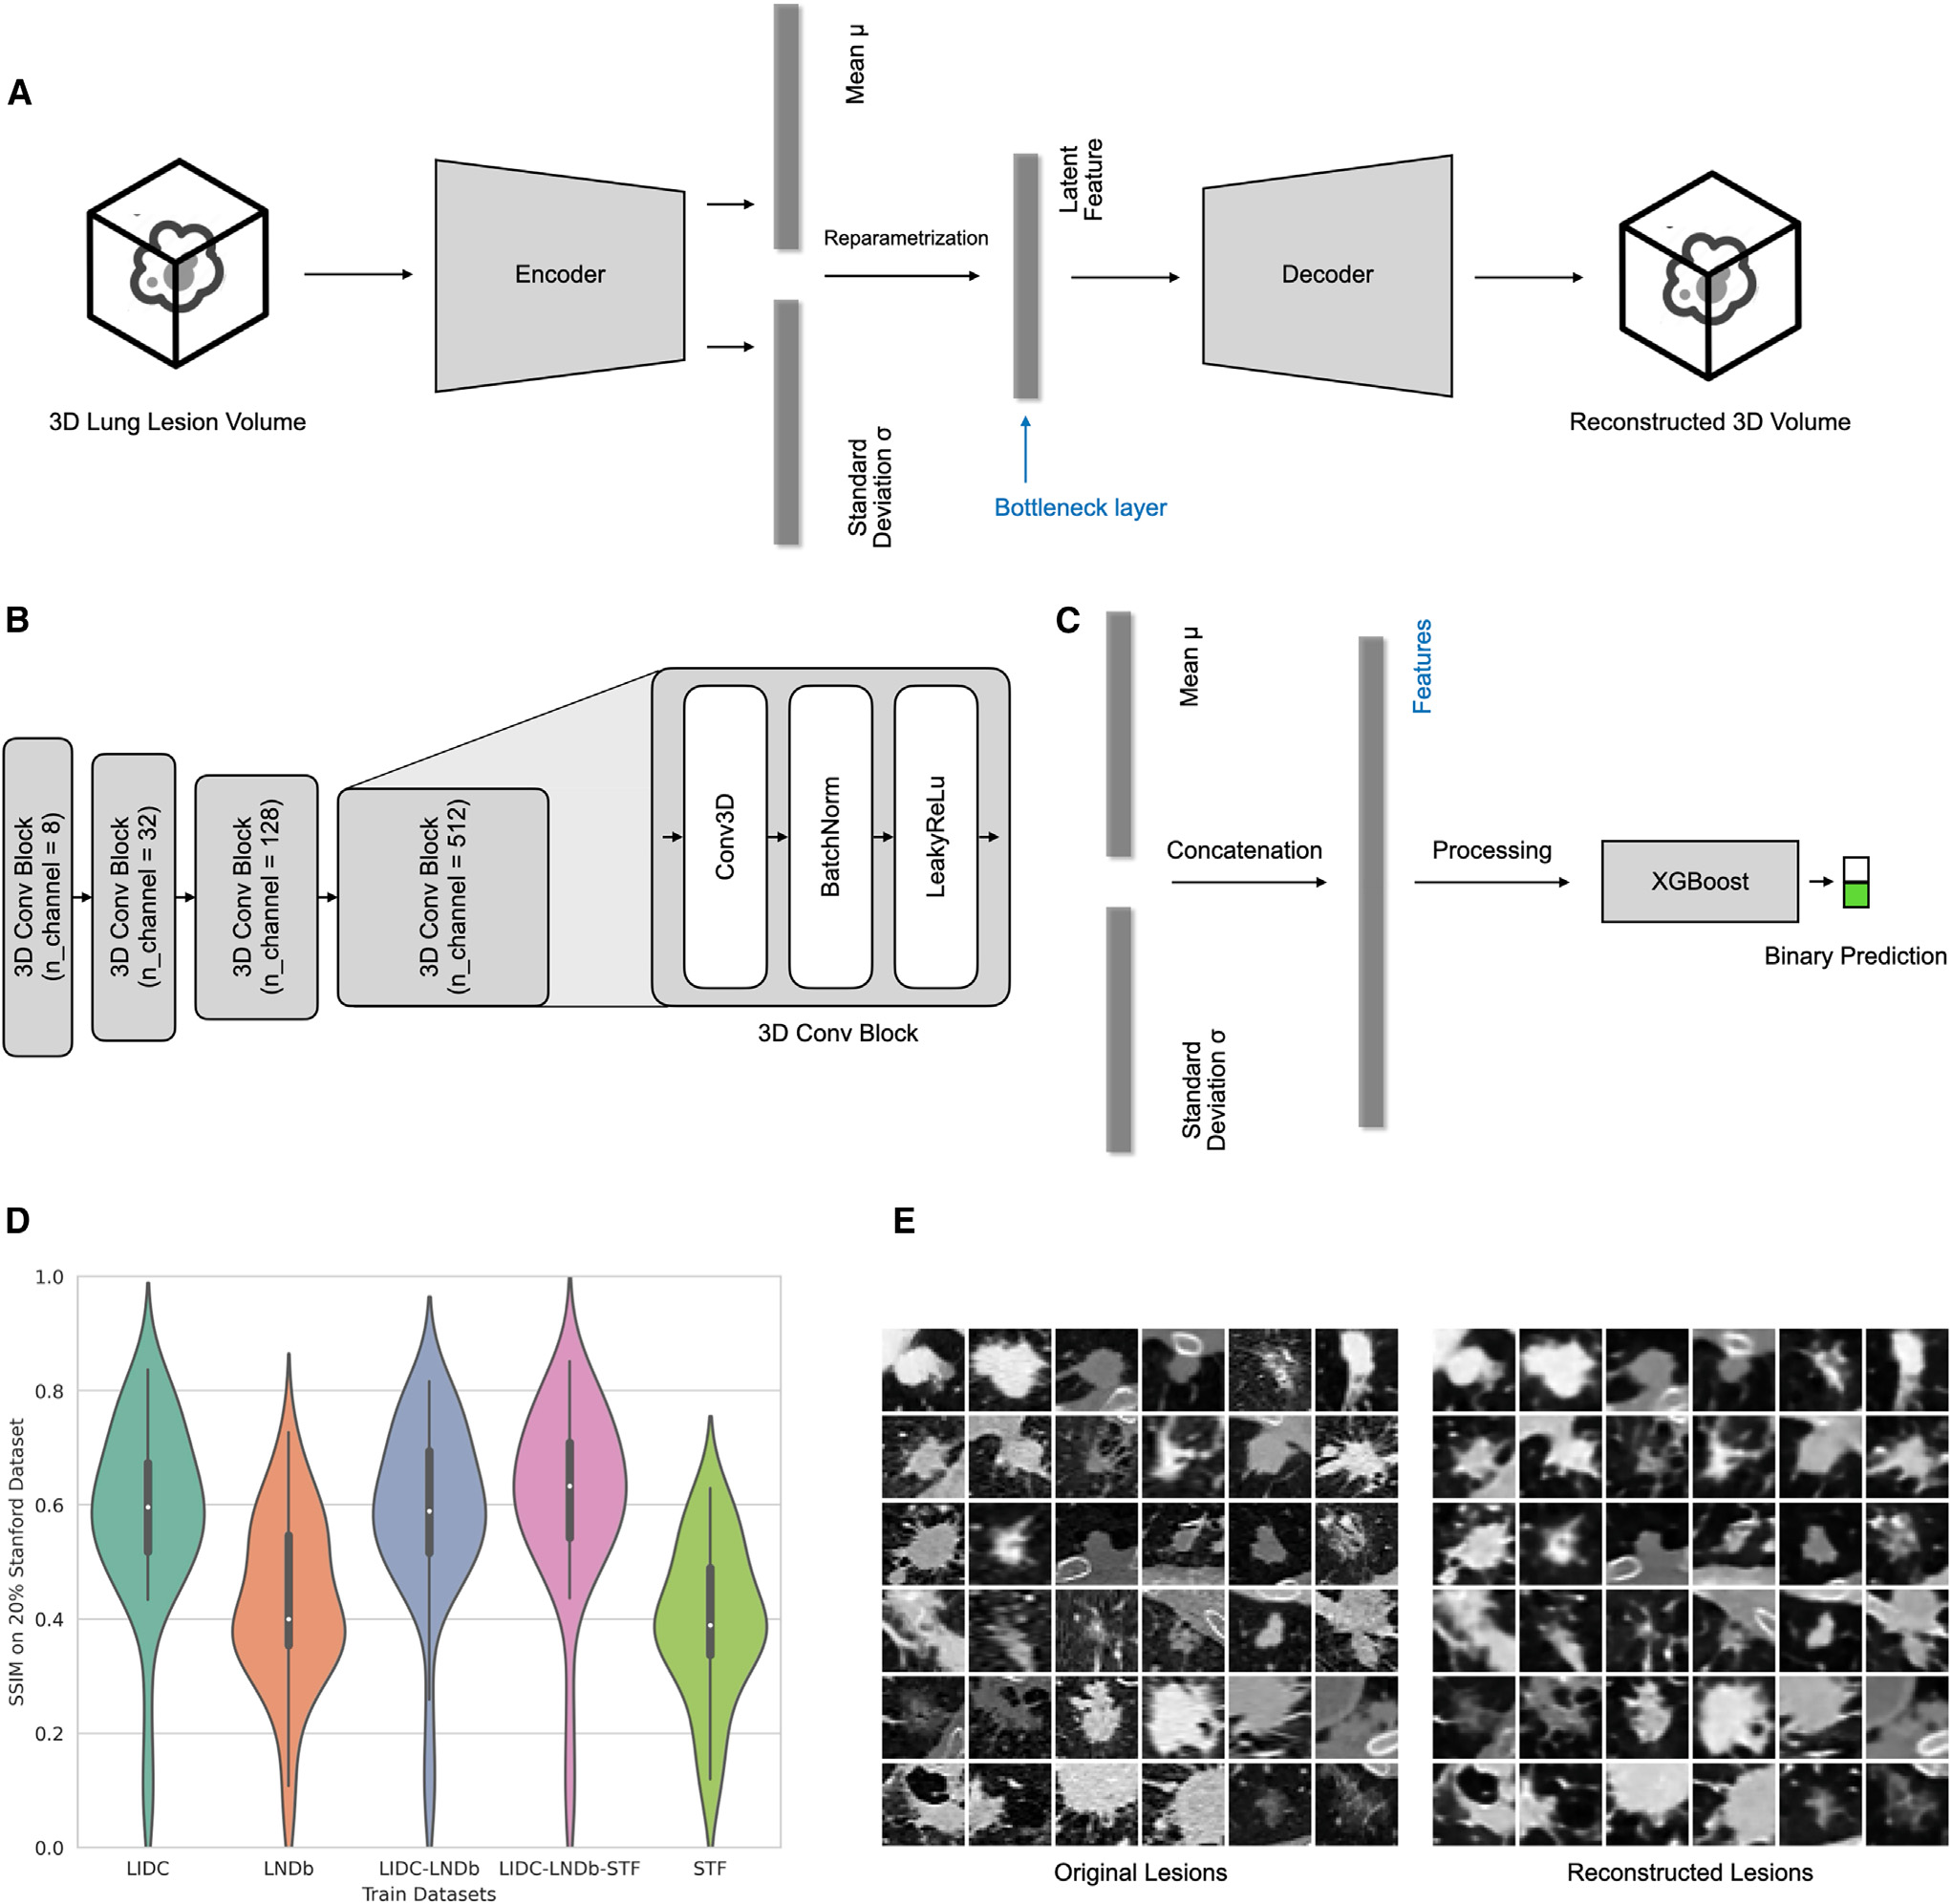 整体流程:(A)编码器、瓶颈和解码器;(B)编码器的四个 3D 卷积模块;(C)学到的数字输入 XGBoost 分类器;(D)用不同训练数据训练的模型在 Stanford 测试病灶上的重建质量;(E)原始病灶和对应的重建结果并排对比。Figure 1, Li et al., Cell Reports Methods 2024, CC BY-NC-ND.
数据
我们用三个来源的病灶做训练:两个公开数据集 LIDC-IDRI(美国)和 LNDb(葡萄牙),两者加起来有几千个标注过的肺结节,良性和恶性都有;还有一个 Stanford 放射基因组学(radiogenomics)队列,包含 143 名非小细胞肺癌患者。只有 Stanford 队列有我们想预测的临床和基因结局,所以下游测试都在这个队列上做。
关于“不用标签”,有一点需要老实说明:影像块是围绕每个病灶的中心切出来的,而这个中心来自标注。标一个中心点比勾画完整边界便宜得多,但仍然需要一些人工输入。这一步里模型始终没有见过的,是结局。
重画的效果
我们用 SSIM 衡量重建质量,这个分数衡量两张图在结构上看起来有多相似,最高为 1,1 表示完全相同。在留出的(held-out)Stanford 病灶上,用全部三个数据集训练的模型 SSIM 达到 0.774,峰值信噪比(peak signal-to-noise ratio)为 26.1,均方误差(mean squared error)为 0.0008(这是另外两种衡量重画结果和原图差多远的方法)。从上图的 E 部分可以看到,重建结果保留了每个病灶的整体形状和位置,但比原图更平滑。
更有用的发现在 D 部分。只用单个数据集训练的模型表现最差,用三个数据集一起训练的模型表现最好。把来自不同医院、不同扫描仪的影像混在一起是有帮助的。如果设想这类模型会随着越来越多的机构贡献影像而不断改进,这一点就很重要。
1,024 个数字里装了什么
1,024 个数字很难直接看,所以我们用了 UMAP,这种方法把高维数据压到二维,同时尽量让原本相近的点仍然相近。我们按每个病灶的体积设定它在图上那个点的大小,结果小病灶和大病灶落在了图上不同的区域,图上的位置和病灶大小之间的相关性是显著的(p < 0.001,这说明这种关联不太可能是偶然出现的,但不说明它有多强,也不说明它预测得有多好)。大小是最容易被学到的东西,但它证明了瓶颈确实保留了一些真实的信息。
转动“大小”这个旋钮
因为 VAE 还有一个解码器,我们可以做一件影像组学和有监督 CNN 都做不到的事:改动这些数字,看看会画出什么样的图像。
我们取 Stanford 最大的那批病灶编码的平均值,和最小的那批病灶编码的平均值,两者相减。这个差值是编码空间里的一个方向,大致代表“更大”。把它加到随机抽取的 36 个 Stanford 病灶的编码上再解码,得到的是变大的病灶;减去它,得到的是变小的病灶。我们测量了解码后病灶的体积,缩小的比原来小,放大的比原来大,和预期一致。
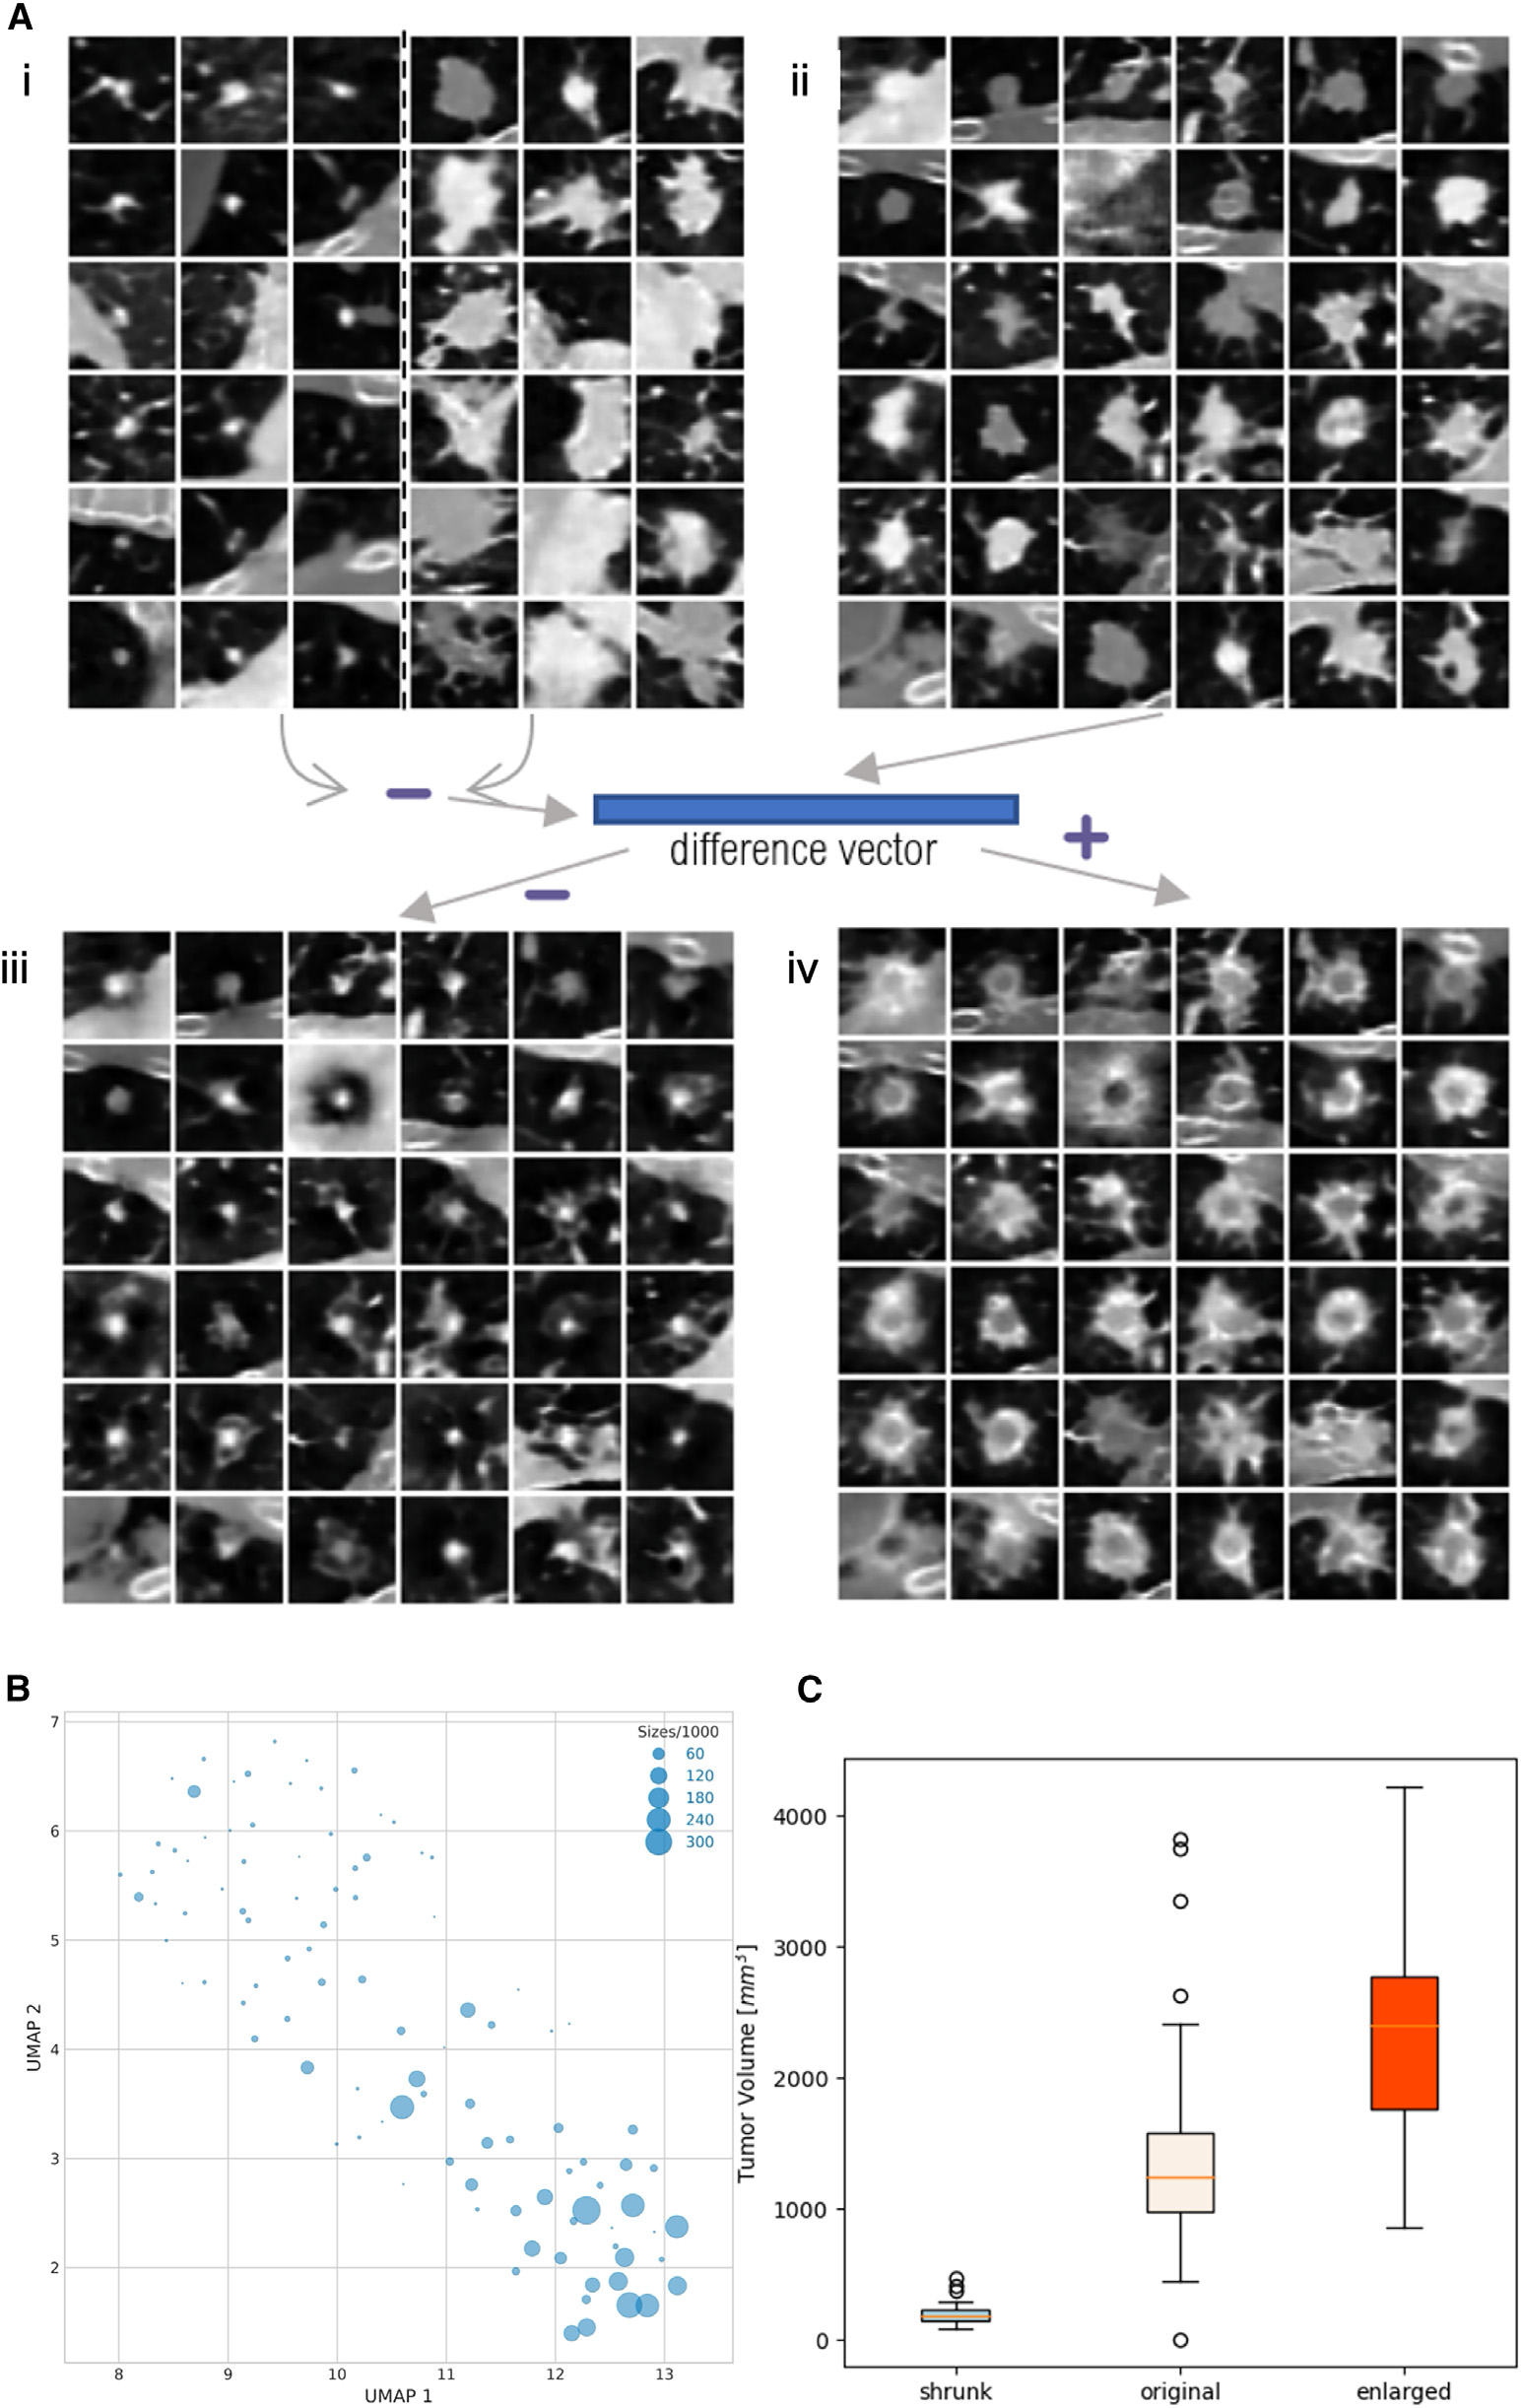 (A)小的和大的参考病灶确定一个大小方向,再把这个方向从其他病灶上减去或加上;(B)二维 UMAP 图,点的大小表示病灶体积;(C)缩小后、原始和放大后病灶的实测体积。Figure 2, Li et al., Cell Reports Methods 2024, CC BY-NC-ND.
这是我觉得这个项目最有意思的地方。解码器在图像和数字之间搭了一座双向的桥。如果数字空间里的某个方向看起来对预测有影响,就可以沿着这个方向解码,看看图像里有什么变化。这是解释一个特征代表什么的一种具体办法,这样的解释也许能帮助临床医生信任模型,不过我们没有检验这一点。
局限也同样明显。这些是生成出来的图像,不是对真实患者的肿瘤会怎样生长的预测。放大后的病灶出现了中空的样子,缩小后的病灶变得更圆、更均匀。沿这个方向推得太远,形状就会失真(论文的补充材料 Figure S3 和 S4 展示了这一点)。而且我们只演示了大小这一个属性,其他方向,比如纹理或边缘形状,都还没有测试过。
把特征拿去做预测
检验一个可复用的表示(representation),真正要看的是它对训练时从没碰过的问题有没有帮助。在 Stanford 队列上,我们把六个临床问题设成是或否的预测,包括 KRAS 突变状态(这个基因的突变会影响治疗选择)、EGFR 突变状态、淋巴血管侵犯(lymphovascular invasion,即癌细胞进入血管或淋巴管)、病理 T 分期(肿瘤大小和局部范围,T1 对比更高分期)、病理 N 分期(癌症是否已扩散到淋巴结,N0 对比更高分期),以及 AJCC 总分期(综合分期,I 期对比更高分期)。对每个问题,我们比较了四组特征:影像组学、针对该问题端到端训练的 CNN、VAE 特征,以及影像组学和 VAE 特征的组合。性能用 F1 衡量,这是一个 0 到 1 的分数,在找出阳性病例和避免误报之间取一个平衡,评估方式是十折交叉验证(tenfold cross-validation,把数据分成十份,轮流用每一份做测试)。
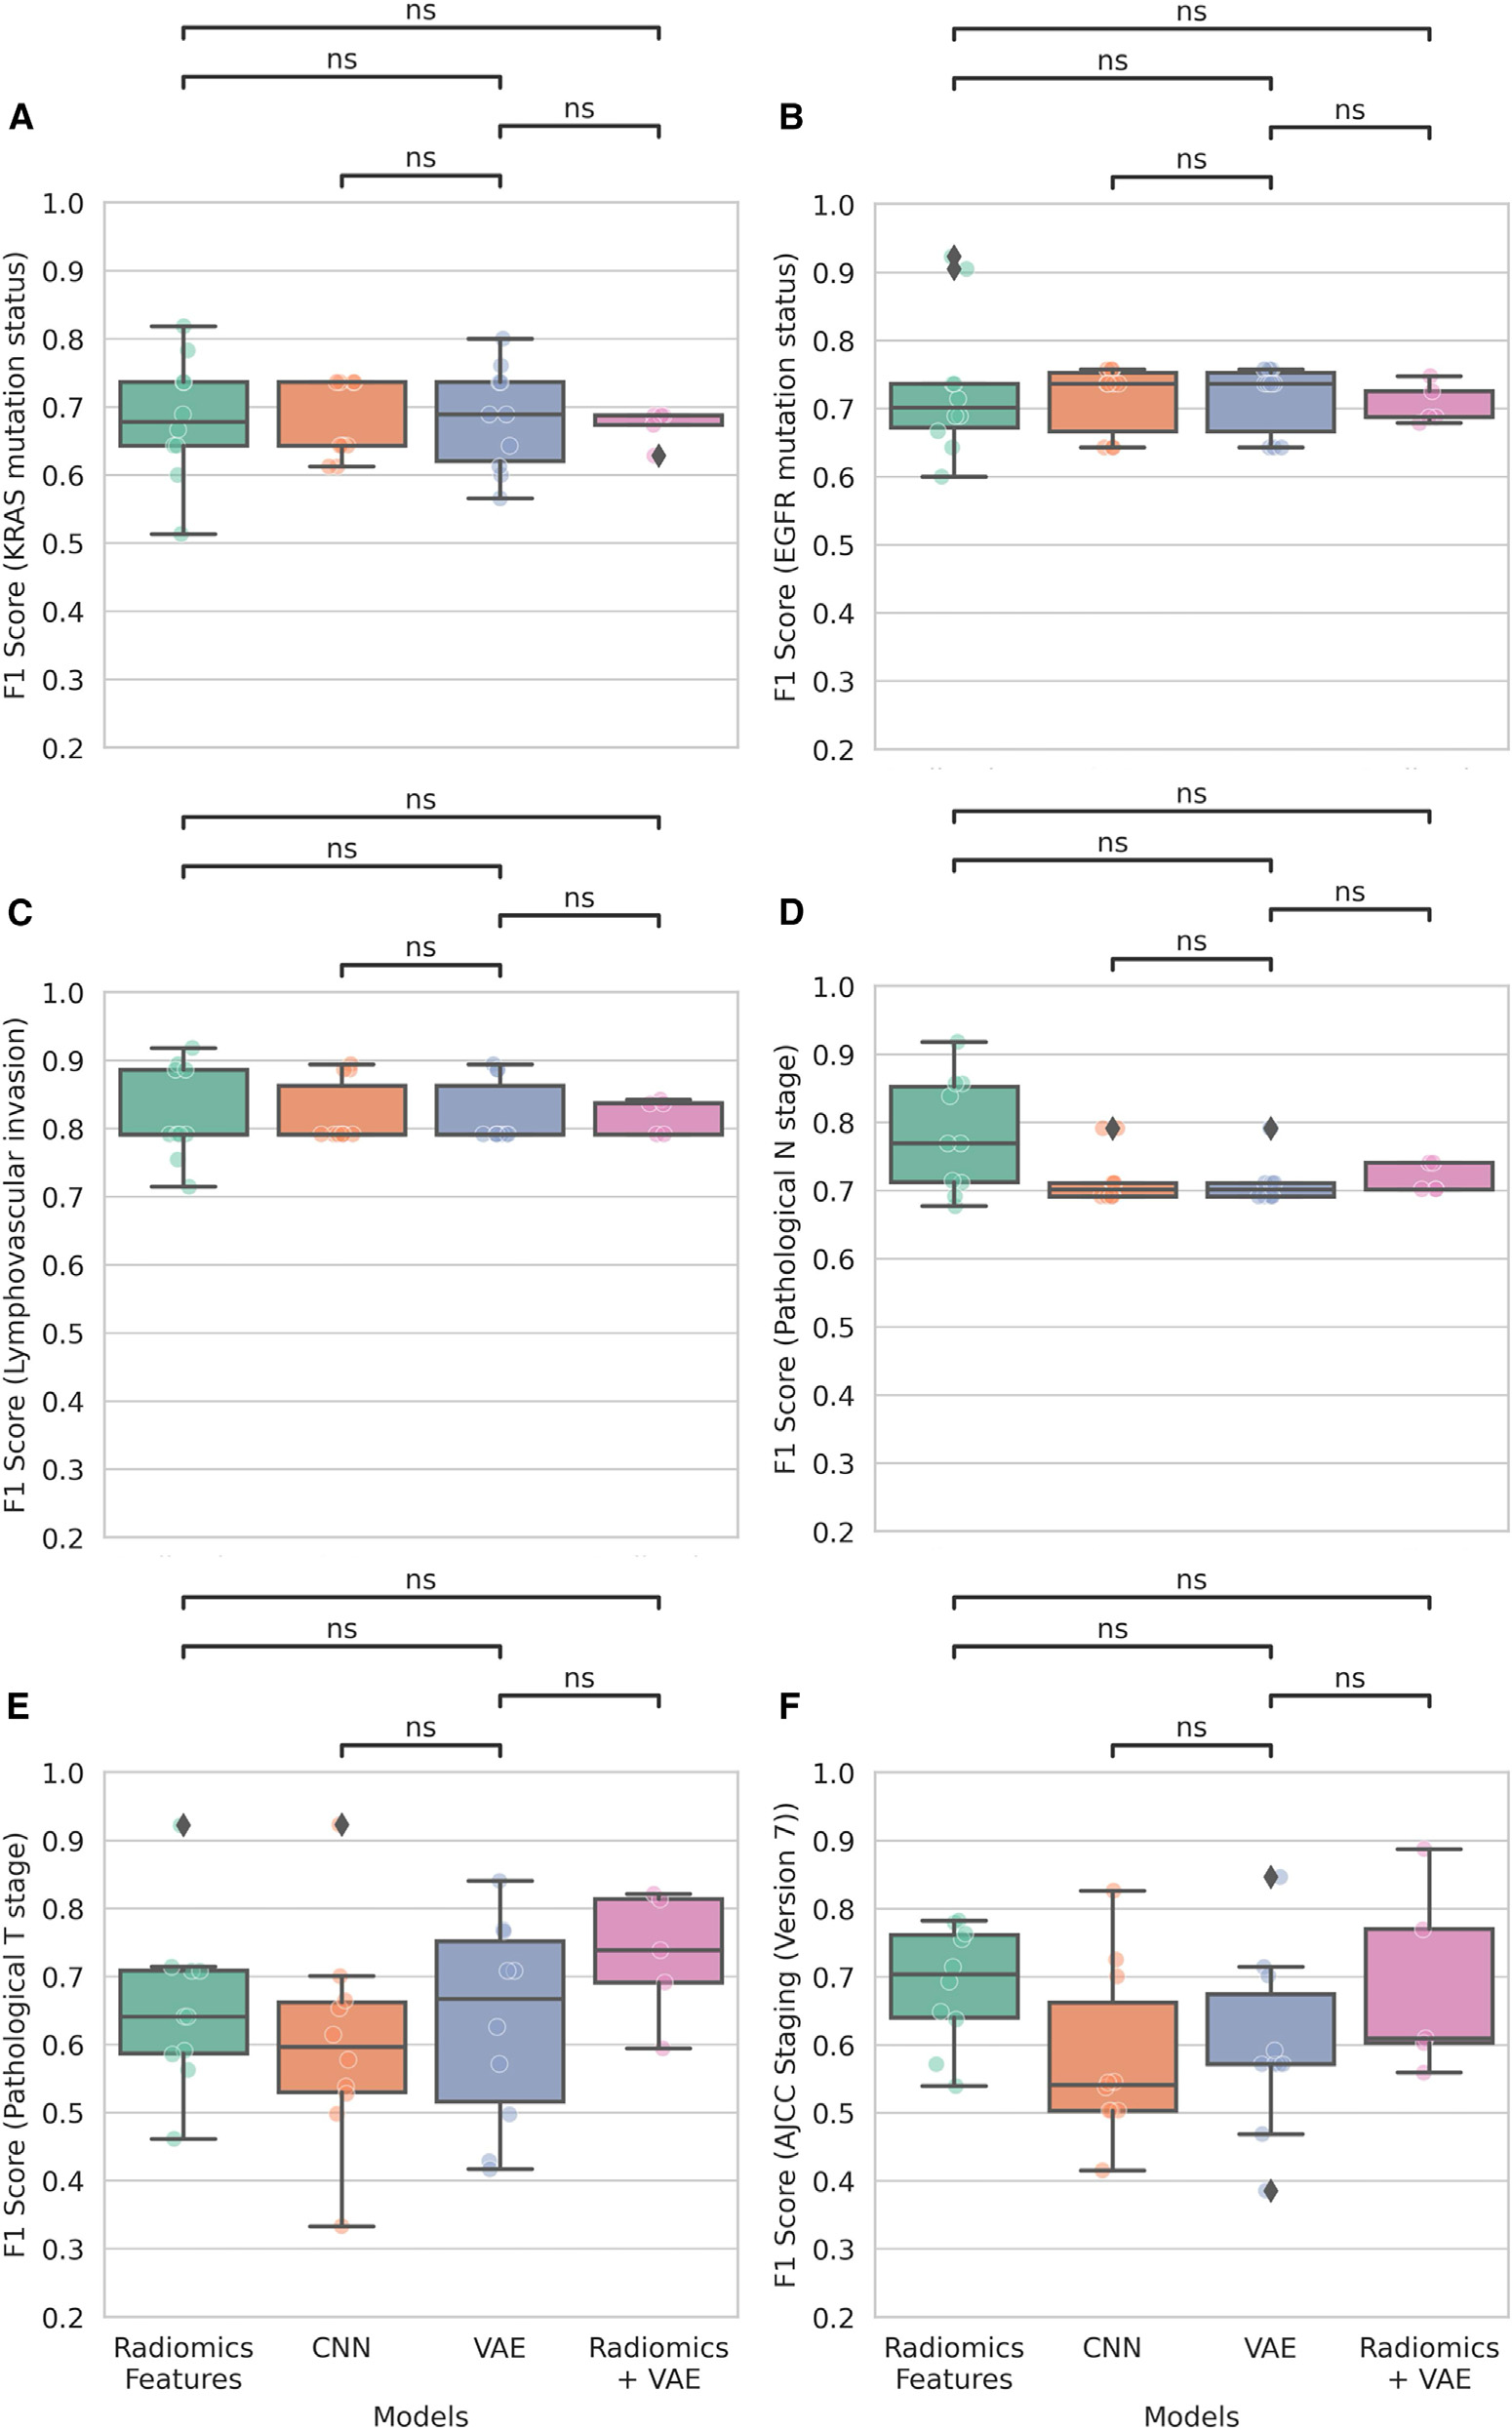 影像组学、有监督 CNN、VAE 特征,以及影像组学加 VAE 特征,在 Stanford 队列六个临床终点上的 F1 分数;“ns”表示差异没有统计学显著性。Figure 3, Li et al., Cell Reports Methods 2024, CC BY-NC-ND.
在全部六个终点上,VAE 和其他方法之间的差异都没有达到统计学显著。在 KRAS 上,VAE 的分数和影像组学、CNN 看起来差不多。在 N 分期上,影像组学的分数在图上明显更高,尽管检验并没有判定这个差异显著。比较公允的总结是:只靠重画学到的特征,表现和依赖精细病灶边界的人工设计特征处在同一范围,也和针对每个标签直接训练的 CNN 处在同一范围。这正是我在意的结果:单靠重建,就得到了对后续任务有用的特征。
这组比较也说明了影像组学和病灶掩膜的价值:它们携带了真实的信息,VAE 并没有超过它们。把两组特征结合起来,也没有带来显著提升。
这项工作没有说明什么
它没有说明 VAE 比影像组学好,也没有说明两者在统计上等价。在 143 名患者的队列上得出“没有显著差异”,无论往哪个方向解读,都是一个很弱的结论。
它没有消除对标签的需求。找到病灶仍然要用到标注,每个下游预测器也仍然需要结局标签来训练。变化在于,代价最高的表示学习这一步不再需要标签。
它也不是在一家完全没接触过的外部医院上做的干净测试。Stanford 的数据是 VAE 合并训练集的一部分,模型选择用的是其中留出的一部分。
另外,调节大小只是展示编码里包含了什么,并不是一个肿瘤生长模型。
这个项目的位置
我用三个问题来梳理自己的研究:用什么数据,怎么训练,怎么评估。这个项目对应的是训练。医学标签要花专家的时间,所以我们尝试从影像本身学习,再把学到的东西复用到几个任务上。《入院时用 CT、病历和化验预测新冠重症》那篇讲的是数据问题:把一次扫描和关于患者的其他已知信息结合起来。《八个胸片模型、九个数据集,以及一个分数看不到的东西》那篇讲的是评估:一个在留出数据上看起来不错的模型,换了医院、患者或任务,表现仍然可能变化,而选择怎么衡量这种变化,和模型本身一样重要。
2026 年 9 月,我在 OpenRefinery 的讲座 “AI for Biomedicine” 中把这三个项目放在一起讲过。录像在这里:https://www.youtube.com/watch?v=Kz_LV64xKjE
论文是开放获取的:Li Y., Sadée C.Y., Carrillo-Perez F., Selby H.M., Thieme A.H., Gevaert O. “A 3D lung lesion variational autoencoder.” Cell Reports Methods 4(2):100695, 2024. https://doi.org/10.1016/j.crmeth.2024.100695. 代码在这里:https://github.com/gevaertlab/Variational-Auto-Encoder