CASE · 2026CASE · 2026
八个胸片模型、九个数据集,以及一个分数看不到的东西
我们在六个公开数据集和三个私有数据集上运行了八个已发表的胸片 AI 模型,发现哪个模型看起来最好,取决于统计哪些征象、用什么指标,以及在哪些患者身上测试。
胸部 X 光片(chest X-ray,简称胸片)是全世界使用最广泛的诊断影像检查之一。现在已经有很多已发表的模型,可以看一张胸片,判断它是否显示肺炎、肺周围积液、肺塌陷、骨折,或者其他几十种征象(finding)。以往的评估大多用的是美国的数据集或单一机构的数据集。在留出测试集(held-out test set,也就是模型训练时从没见过的图像)上的分数,说明模型学到了一些东西。但模型遇到另一家医院、另一类患者,或者一个它本来不是为之设计的问题时会怎样,这个分数能说明的就少得多。
这个项目关注的就是这个差距。我和 Qinmei Xu(我们贡献相同)、Olivier Gevaert,以及斯坦福和南京几家医院的同事一起,选了八个公开可用的胸片模型,把它们全部在六个公开数据集和三个来自中国的私有数据集上运行了一遍。背后的问题是关于评估的:医院、患者或任务变了,模型的表现会变化多少;我们报告的数字,又是否符合模型实际被使用的方式。
模型和数据
这八个模型分成两类。三个是传统的纯图像模型,用带标注的胸片训练:DenseNet、ResNet 和 X-Raydar。每个模型都是针对一份固定的征象列表训练的,所以只能回答列表上的问题。另外五个是视觉-语言模型(vision-language model):CheXzero、BioViL-T、MAVL、MedKLIP 和 PsPG。它们从胸片和放射科医生所写报告的配对中学习,所以能把图像的样子和描述它的文字联系起来。有些视觉-语言模型可以根据新的文字描述做分类,但我们评估的这些实现支持的征象各不相同。比如 MAVL 公开发布的词典包含 24 个预定义标签。
数据方面,我们用了六个公开数据集(CheXpert、NIH (Google)、OpenI、VinDr-CXR、PadChest 和 MIDRC),以及来自中国四家医院的三个私有数据集。公开数据集一共给出 37 个分类任务,包括肺炎和胸腔积液。私有数据集覆盖四种征象:气胸(pneumothorax,即肺塌陷)、肺炎、胸腔积液(pleural effusion,即肺周围有积液)和骨折。其中一个数据集是 371 张儿童胸片,结果它的重要性超出了它的规模。
为什么公平比较很难
每个模型对图像的准备方式都有自己的要求,所以我们先把所有图像转换成同一种通用格式,再分别套用每个模型自己的处理步骤。更大的问题是,这些模型回答的不是同一组问题。在 37 个公开征象中,DenseNet 和 ResNet 能评分的有 17 个,X-Raydar 16 个,MAVL 和 MedKLIP 24 个,BioViL-T、CheXzero 和 PsPG 则 37 个全部能评。在不同征象集合上算出的平均值,不是一个受控的比较。所以我们给出两种视角:每个模型在它能尝试的全部征象上的结果,以及八个模型在 11 个它们全都能评分的征象上的结果。
还有一个可能的重叠问题。我们测试用的几个公开数据集,包括 CheXpert 和 PadChest,也被列为部分模型的训练数据来源,而预印本没有量化这些模型见过多少测试数据。对这些模型来说,公开数据上的结果有一部分可能是在熟悉的材料上做的测试。这也是私有医院数据重要的原因之一。
排名取决于你统计什么
在 11 个共有征象上,按 AUROC 和 AUPRC 相加来算(AUPRC 后面会解释),MAVL 在其中 7 个上排第一,它的平均 AUROC 也最高,为 0.88,MedKLIP 为 0.87。AUROC(受试者工作特征曲线下面积,area under the receiver operating characteristic curve)衡量的是模型区分有目标征象和没有目标征象的图像的能力。它等于这样一个概率:随机取一个阳性病例和一个阴性病例,模型给阳性病例打的分更高。0.5 相当于抛硬币,1.0 表示排序完全正确。
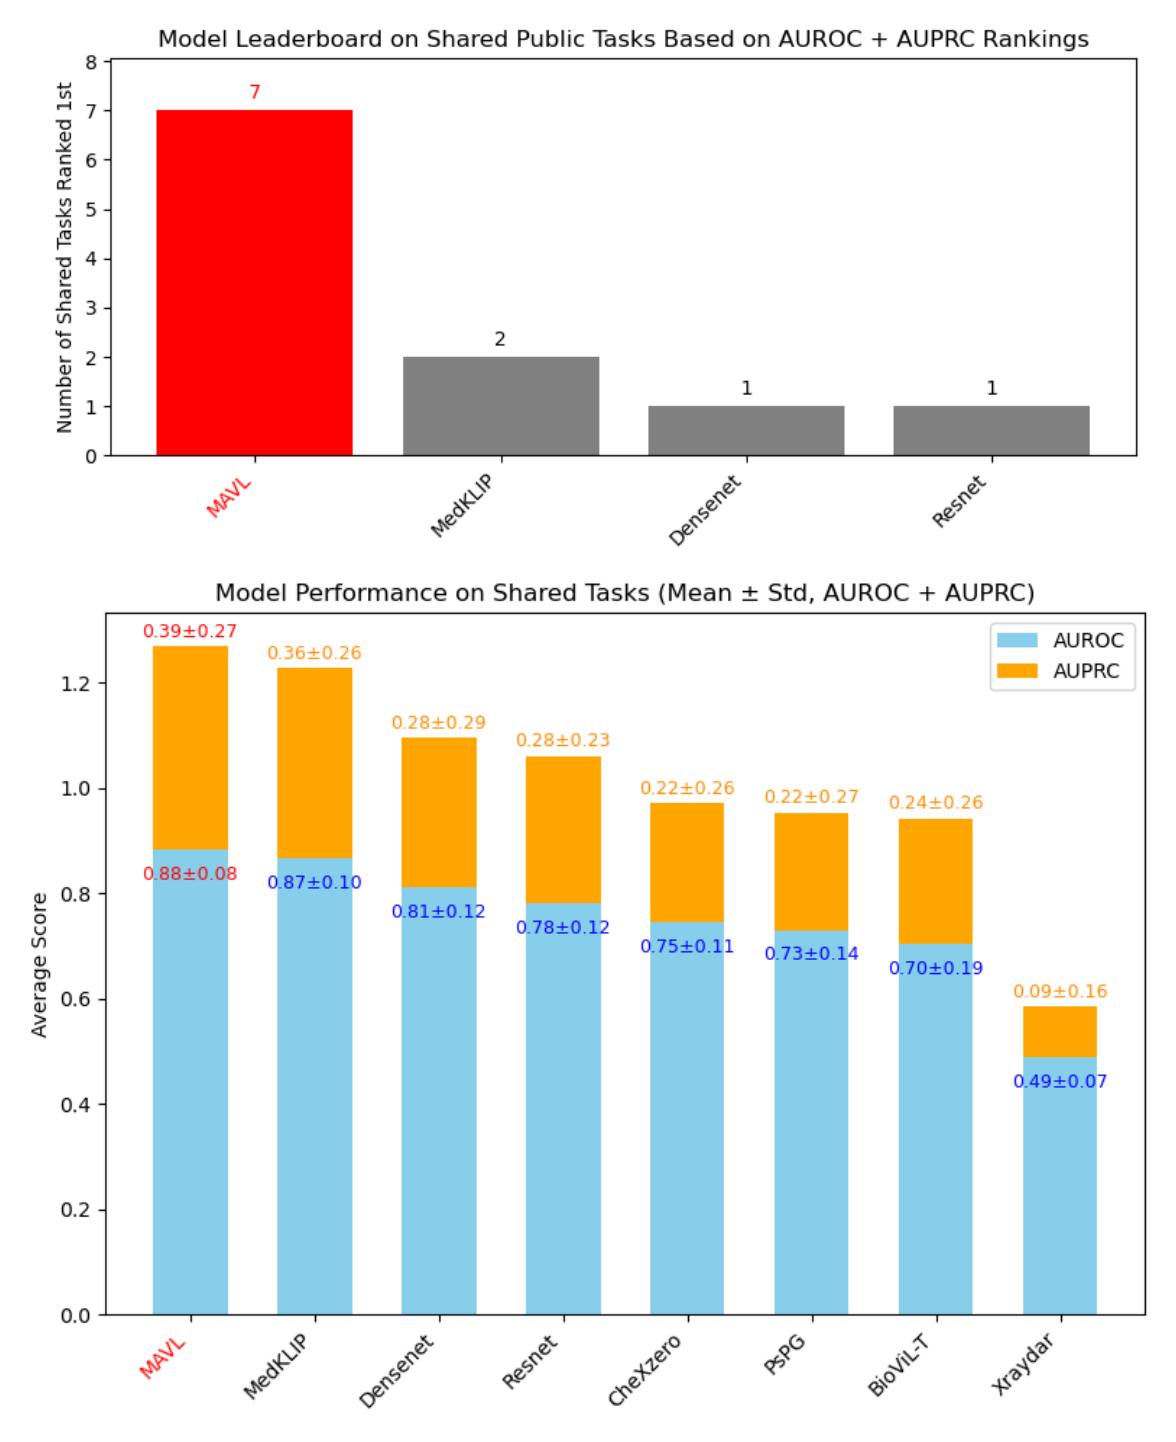 八个模型都能评分的 11 个征象:各模型按 AUROC 与 AUPRC 之和排第一的次数(上),以及各模型的平均 AUROC(蓝)和 AUPRC(橙)(下)。Figure 3, Xu, Li et al., arXiv:2505.16027 (2025), CC BY 4.0.
我们认为,MAVL 的结构化描述可能是它领先的原因之一。它把每种疾病的描述拆成几个部分,比如阴影的密度、形状、所在位置和纹理,并学习把每个部分和图像对应起来。这个基准比较的是不同模型之间的结果,所以并不能证明是哪个设计组件造成了这些差异。
换一种统计方式,情况就不一样了。在每个模型能尝试的全部征象上,BioViL-T、CheXzero 和 PsPG 覆盖了全部 37 个,但平均 AUROC 只有 0.65 左右;MAVL 覆盖 24 个,平均 0.82,和 DenseNet 在它的 17 个征象上的结果一样。预印本把较低的平均值部分归因于罕见或标注含糊的征象,其中一些分数接近 0.5,不过也有一些高得多。一个模型能被问某个问题,不等于它能把这个问题答好;只显示平均值的排行榜会把这种取舍藏起来。
排序分数好,也可能藏着大量误报
让我改变对这个项目看法的那个数字,在图 2 里就挨着 AUROC。在公开数据上,MAVL 的平均 AUROC 是 0.82,但平均 AUPRC 是 0.32。AUPRC(精确率-召回率曲线下面积,area under the precision-recall curve)问的是另一个问题。精确率(precision)是被模型标记的图像中真正病例所占的比例,召回率(recall)是真正病例中被模型找出来的比例;AUPRC 概括的是阈值变化时这两者如何此消彼长。AUPRC 为 0.32 并不是某个特定阈值下的精确率。我们把它和 AUROC 一起报告,用来评估阳性病例稀少时模型找出它们的能力,论文也指出了模型在几个罕见或标注含糊的征象上表现较弱。
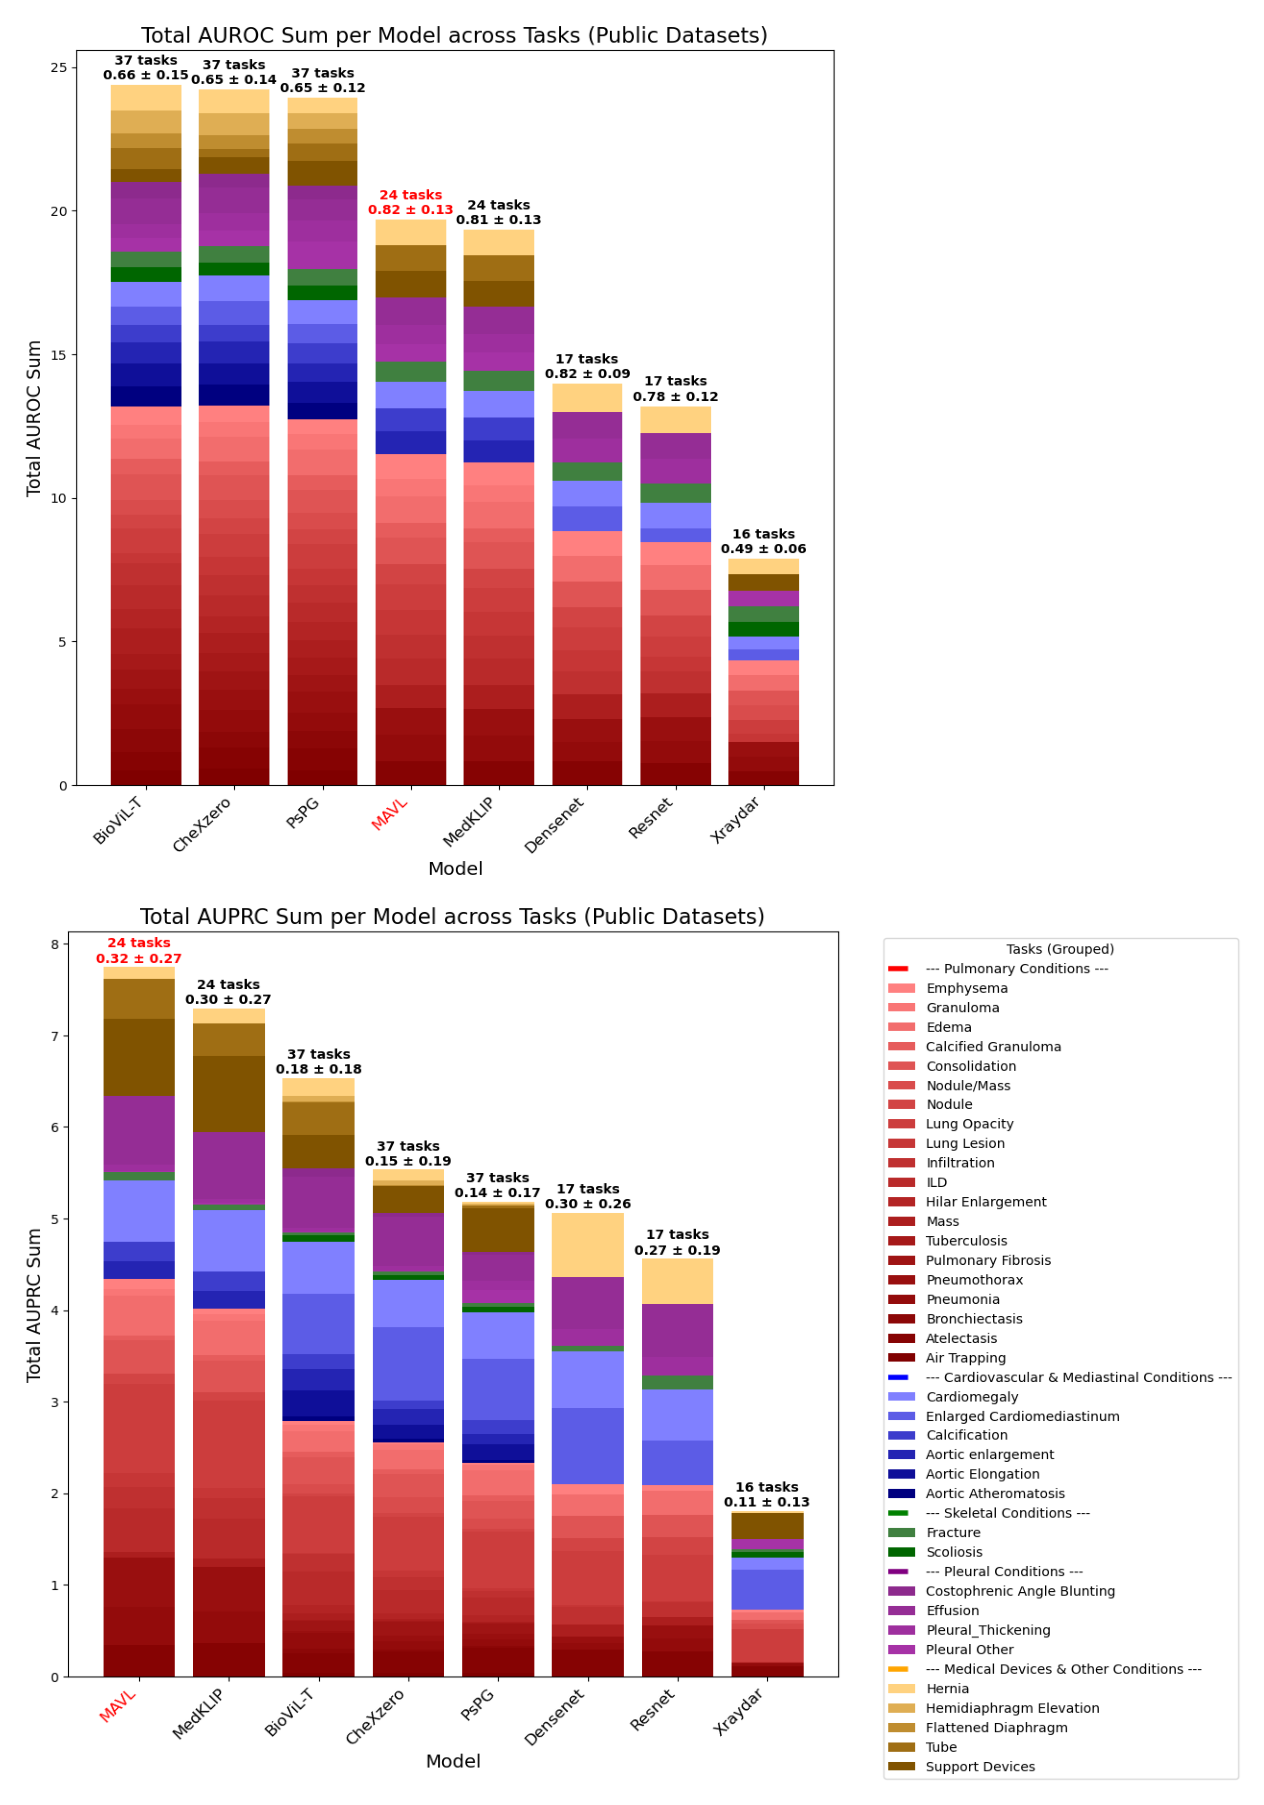 各模型在公开数据上能尝试的全部征象:AUROC 之和(上)与 AUPRC 之和(下),每根柱子上方标有征象数和平均值。Figure 2, Xu, Li et al., arXiv:2505.16027 (2025), CC BY 4.0.
我说我们最常用的指标可能和临床用途对不上,指的就是这个。在医院里,模型不是一个排序,而是一条规则:分数超过某个水平,就有人采取行动。放射科医生优先阅读这张片子,患者被召回复查,报告被标记出来。选这个水平,是在安全和效率之间做取舍。烟雾报警器是个合适的类比:你会把它设成优先保证发现火情,然后真正要问的就是它有多经常因为烤面包而响。对这类用途,你会把灵敏度(sensitivity)固定在很高的水平,也就是模型几乎能抓住每一个真正的病例,然后去衡量它仍然会标记多少张没有该征象的图像,以及一次标记有多大概率是对的。曲线上的这个点就是工作点(operating point),单一的 AUROC 并不能告诉你在这个点上会发生什么。主要结果侧重 AUROC 和 AUPRC,所以没有直接回答这个问题。而在使用一个模型之前,这是我会问的第一个问题。
换了患者,表现就变了
最清楚的例子来自儿童。我们测试的每个模型都是用成人胸片训练的。对南京几家医院成人患者的肺炎,八个模型的平均 AUROC 是 0.81。在同一地区的 371 张儿童胸片上,平均为 0.57,离抛硬币不远。MAVL 从 0.95 降到 0.81,CheXzero 从 0.79 降到 0.53。因为只有八个模型,我们用了自助法(bootstrap),也就是对观测到的结果反复重抽样,来估计不确定性。迭代 10,000 次后,平均 AUROC 下降幅度的 95% 置信区间为 0.034 到 0.462,p = 0.0202。
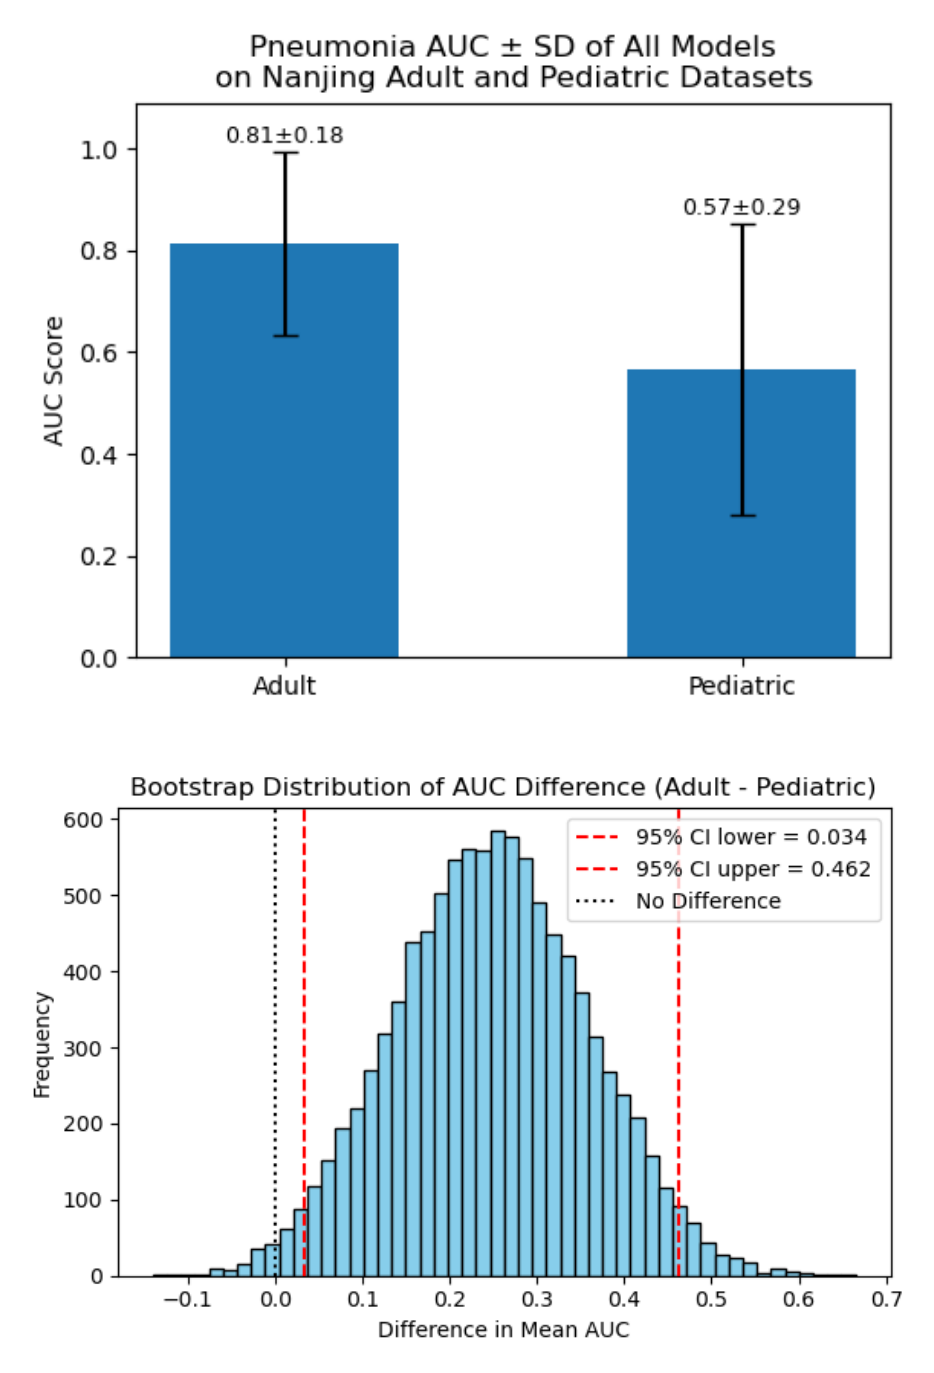 八个模型的肺炎 AUROC,成人对比儿童(上),以及两者差值的自助法分布(下)。Figure 7, Xu, Li et al., arXiv:2505.16027 (2025), CC BY 4.0.
儿童和成人在解剖结构和影像表现上都不一样。只在成人身上做评估,并不能确定模型在儿童身上表现如何。在这个基准中,各模型的表现都有下降,但下降程度不同。
第二个例子:X-Raydar 的训练数据集包含来自英国国家医疗服务体系(National Health Service)的 2,513,546 个检查,而它在公开数据(16 个任务上平均 AUROC 为 0.49)和私有数据(三个任务上为 0.36,比抛硬币还差)上都排在最后。我们没有单独分析原因,可能是患者、设备或征象定义方式上的差异。不管原因是什么,超大规模训练集的优势没有延续到这些场景中。
有一个结果需要谨慎看待。MAVL 在私有医院数据上的平均 AUROC 比在公开数据上高,0.95 对 0.82,但并不是每个模型都这样。这不代表模型在医院里效果更好。两组平均值覆盖的征象和人群不同:MAVL 的公开平均值涵盖 24 个征象,私有平均值涵盖四个,所以这个比较没法单独分离出换医院带来的影响。
这项研究没有显示的东西
这是一项回顾性研究(retrospective study):用现有的图像,事后评分。预印本报告的是诊断分类性能,不是实测的放射科医生阅片时间变化或患者结局变化。这些需要专门的研究。
主要结果是 AUROC 和 AUPRC。补充材料里也报告了依赖阈值的指标,但预印本没有记录一个统一的临床工作点分析,所以这些主要数字描述的是模型给病例排序的能力,而不是部署后的模型在选定阈值下会怎样表现。
私有数据来自中国的一个地区,儿童的结果只基于一个数据集和一种征象(肺炎)。还有几个公开测试集也被列为部分模型的训练来源,而预印本没有量化这种重叠。另外,我们比较的是八个模型实现,先做统一的图像标准化,再用各模型自己的预处理。用本地数据调整过的模型可能会好得多,所以这里的结果说明的是我们运行时的这些实现,而不是每种设计能达到的最好水平。
我的收获
我记住的教训是:要在你希望使用模型的工作点和场景下评估它。留出集上的分数或排行榜上的名次,并不能告诉你它能否在你的医院减轻工作量或帮助患者。这需要专门的证据,而且模型投入使用之后,评估还要继续。预印本里提到,计划把基准扩展到来自德国、土耳其和日本的数据,并探索把多个模型结合起来使用。
系列文章
我从三个问题来思考自己的研究:数据、训练、评估,也就是用什么数据、怎么训练、怎么评估。这篇是评估那一篇。《入院时用 CT、病历和化验预测新冠重症》讲数据:模型是否像医生一样,能从影像加上患者的其他信息中获益。《让模型学会重画肺部病灶,再把学到的东西拿去用》讲训练:在还没有每种结局的专家标注之前,先学到有用的图像特征。合起来,就是我们用什么信息、从中学到什么,以及怎么知道它会有帮助。
2026 年 9 月,我在 OpenRefinery 的演讲“AI for Biomedicine”中把这三个项目放在一起讲过。录像在这里:https://www.youtube.com/watch?v=Kz_LV64xKjE
预印本可以公开获取:Xu Q., Li Y., Zhan X., Er A.G., Dashevsky B., Xu C., Alawad M., Yang M., Ya L., Zhou C., Li X., Itakura H., Gevaert O. “Benchmarking Chest X-ray Diagnosis Models Across Multinational Datasets.” arXiv:2505.16027 (2025). https://arxiv.org/abs/2505.16027